內容及來源查證:本文只根據 Anthropic 及 Anthropic Platform Docs 的官方資料整理,研究日期為 2026 年 9 月 29 日(香港時間)。官方測試數字不代表香港企業的實際結果;本文已於 2026 年 9 月 29 日發布。
先講結論:更新重點在工作流程選擇
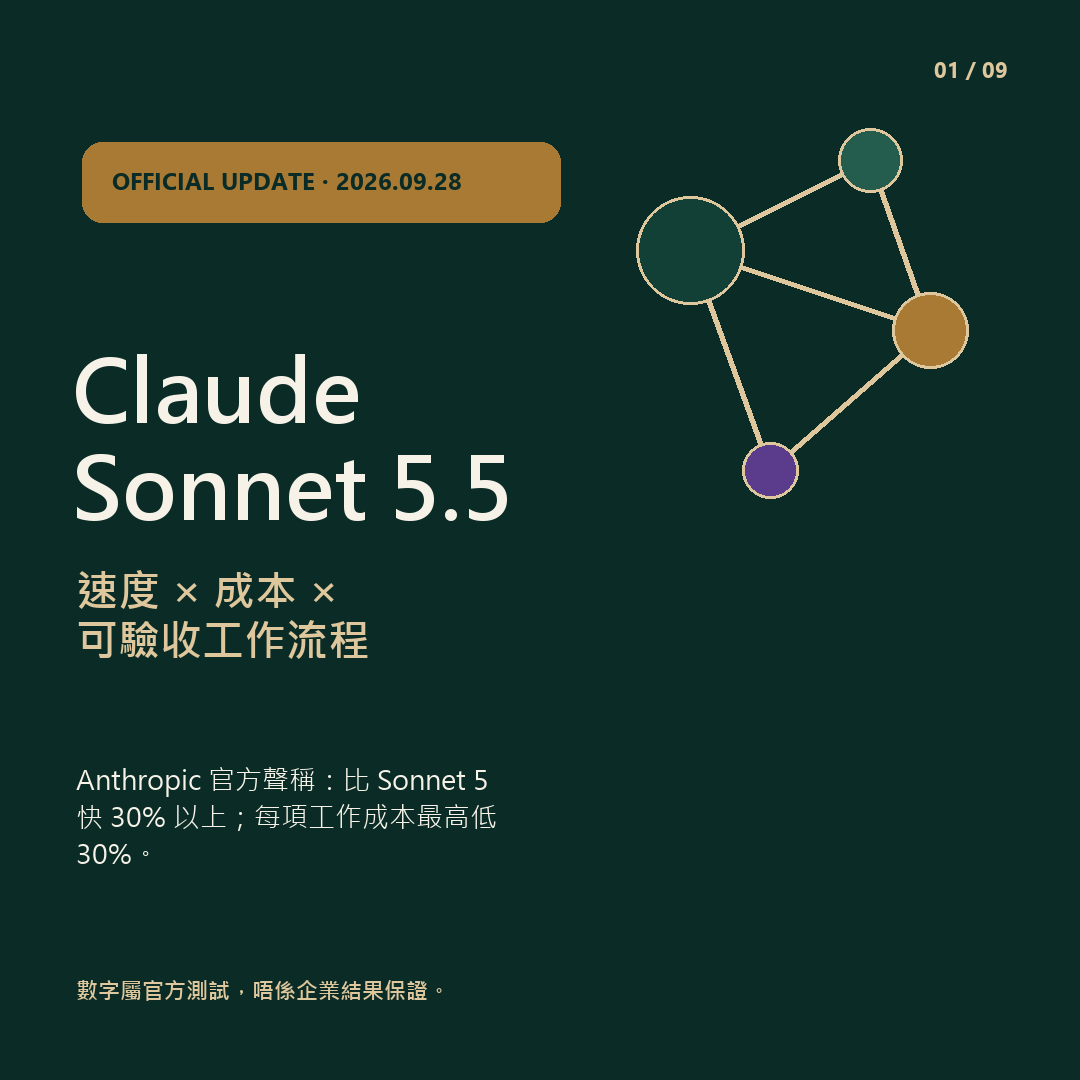
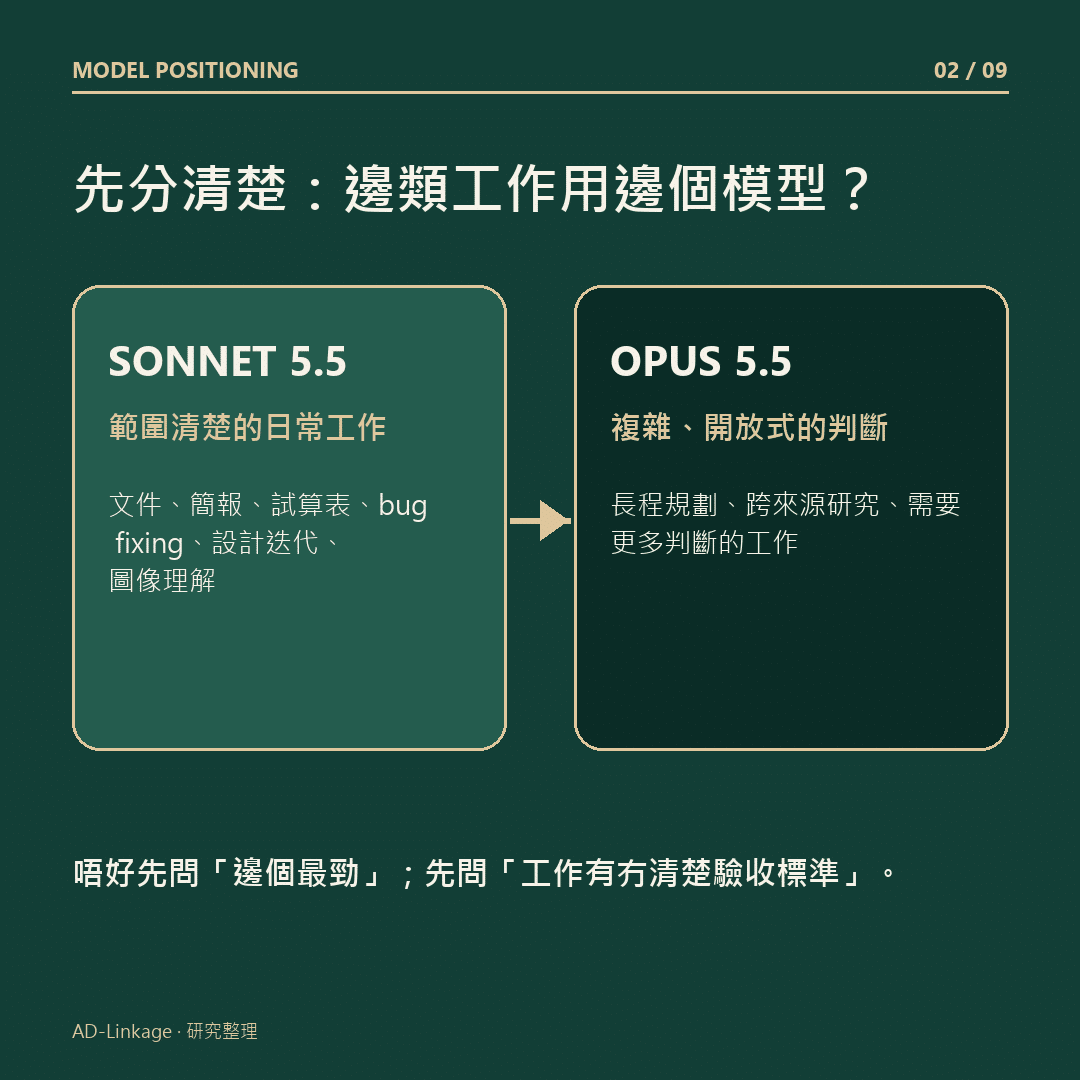
Anthropic 在 2026 年 9 月 28 日公布 Claude Sonnet 5.5。官方把它定位為 Sonnet 5 的較快版本,適合有清晰範圍的日常工作;較複雜、開放式、需要長時間判斷的工作,仍可考慮 Opus 5.5。對香港企業來說,最有用的問題不是「新模型是不是一定更好」,而是「在我們的真實任務上,是否值得遷移」。
這個分別很重要。模型的 token 單價、一次工作的總 token 用量、人工修改時間、錯誤風險及資料政策,會共同決定一個流程是否適合。只看一個 benchmark 或一個「快 30%」的標題,不能代替企業自己的驗收。
官方公布了甚麼
Anthropic 官方頁面列出以下資料:
- Sonnet 5.5 比 Sonnet 5 快 30% 以上;這是 Anthropic 的產品比較說法。
- Anthropic 的測試顯示,Sonnet 5.5 每項工作的成本最高可比 Sonnet 5 低 30%。這是官方測試結果,不是香港團隊的節省承諾。
- 公布的 API 價格為 input 每百萬 tokens US$2、output 每百萬 tokens US$10,cache reads 每百萬 tokens US$0.20。
- Terminal-Bench 4.0 頁面列出 Sonnet 5.5 70.6%,Sonnet 5 10.3%。這是供應商 benchmark,測試設定及任務分布會影響結果。
- 官方列出的 model ID 是
claude-sonnet-5-5,並說明可在 Claude Platform、AWS、Google Cloud 及 Microsoft Azure 使用。 - 官方亦列出 zero data retention 選項,以及針對 cyber 工作的 safeguards 和 fallbacks;生物安全設定則沿用 Sonnet 5 的安排。
以上內容可以作為研究起點,但不能直接推導香港帳戶、付款、地區或企業合約的實際可用性。若團隊要採用,仍須在自己的帳戶、部署方式及資料政策下逐項核對。
速度、token 價格與每項工作成本不是同一件事
「快 30%」可以有幾種不同意思:模型回應時間較短、完成同一任務需要較少 tokens,或者整個工作流程少了等待及重做。企業採購時,應把三者分開記錄。
例如,一個假設中的內容整理任務使用 100,000 input tokens 及 20,000 output tokens,按官方列出的價格計算,API token 成本是:
100,000 × US$2/1,000,000 + 20,000 × US$10/1,000,000 = US$0.40
這只是一個示範算式,沒有計算 cache、平台方案、工具費用、人工審批或重做成本。假設另一模型輸出較長,雖然回應速度相若,總成本仍可能不同;相反,若新模型需要更多人工改寫,企業的實際成本也不會只由 API 單價決定。
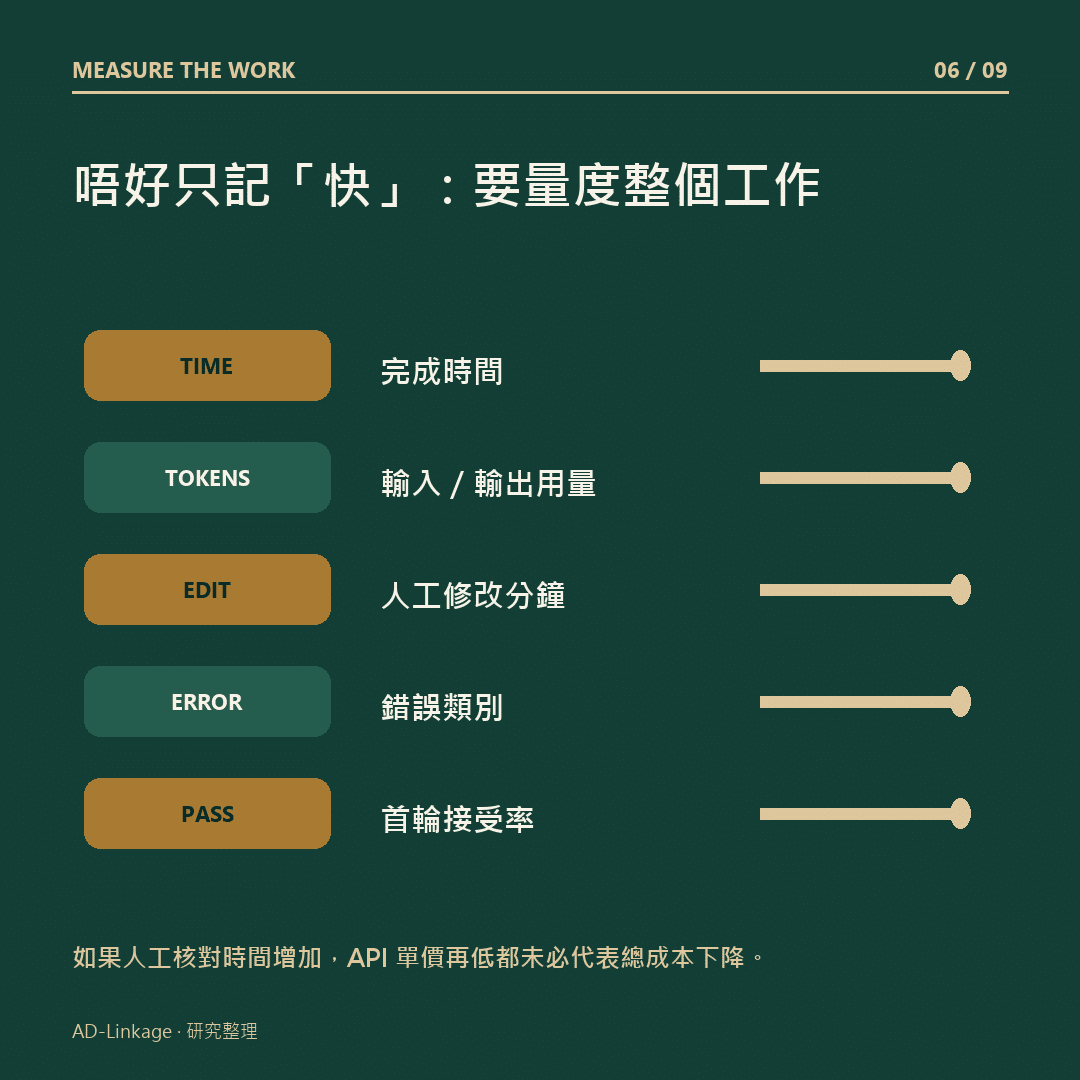
建議團隊同時記錄:從提交到可用輸出的時間、每項任務 token 用量、人工修改分鐘、重做次數及最終可接受率。這樣才知道所謂「較快」是否真的改善了工作交付。
Sonnet 5.5 與 Sonnet 5、Opus 5.5 如何分工
可以先用三個問題作初步分流:
- 任務是否有清楚輸入、格式和完成標準?如果是,Sonnet 5.5 可以作為日常流程的試行對象。
- 任務是否需要長篇研究、跨來源判斷、反覆規劃或高風險決策?如果是,應比較 Opus 5.5 或保留更多人工判斷。
- 團隊是否已經有固定 prompt、資料版本及審批人?如果沒有,先整理流程,否則換模型後仍很難知道問題來自模型還是工作方法。
Anthropic 的 Opus 5.5 頁面提供比較背景,但它不是香港企業的採購建議。實際選擇應以代表性任務、資料敏感程度、可接受錯誤及總成本作決定。
一個香港營銷團隊的實際試行例子
假設一間香港中小企每星期要處理活動 brief、客戶 FAQ、銷售簡報初稿及 campaign reporting。團隊先不要把所有工作一次過搬到新模型,而是選取上星期已完成的 10 至 20 個任務,保留原有輸入資料及 prompt 作 baseline。
第一步:鎖定輸入
把活動目標、受眾、品牌語氣、禁用字、已批准的產品資料及輸出格式放入同一份版本化資料包。若今星期修改了產品價格或條款,要在記錄中標示版本,避免把資料變化誤當成模型進步。
第二步:分開產出與批准
模型可以先產生三個 email 主題、FAQ 草稿或簡報大綱;品牌聲稱、價格、法律用語、客戶資料及圖片版權仍由指定同事核對。這個流程把「產出速度」和「能否直接發布」分開,避免以流暢文字掩蓋事實錯誤。
第三步:記錄可驗收指標
每項任務記錄完成時間、token 用量、人工修改分鐘、錯誤類別和是否通過首輪批准。假設 Sonnet 5.5 令初稿早 5 分鐘完成,但每份文件多花 8 分鐘核對,團隊就應如實記錄,而不是只報告「生成得快」。
這個例子是示範工作方法,不是 AD-Linkage 客戶案例,也沒有聲稱使用 Claude Sonnet 5.5 會帶來固定節省。
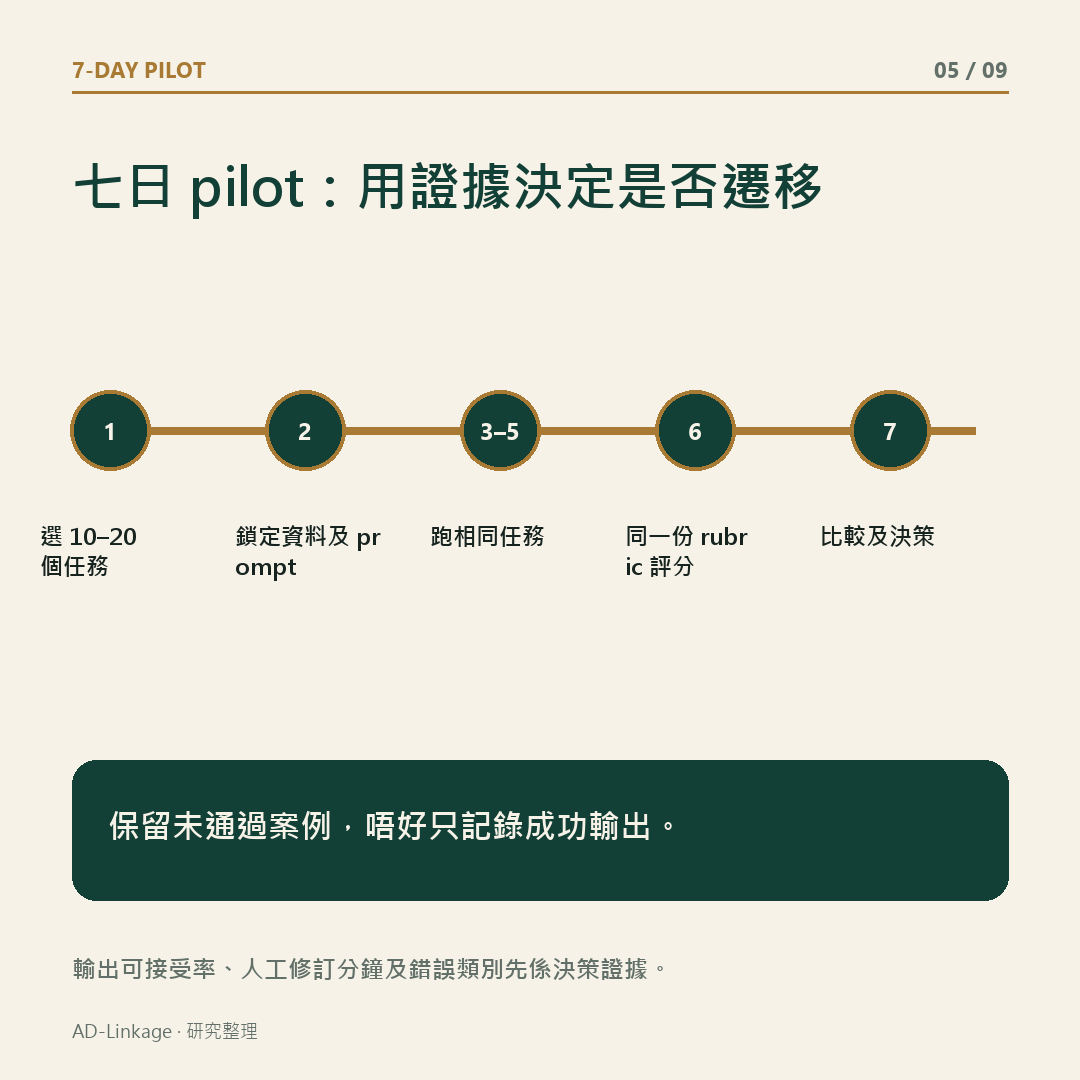
七日 pilot:用工作證據決定是否遷移
一個可重複的七日 pilot 可以按以下方式設計:
- 第 1 日: 選定 10 至 20 個代表性任務,寫下原本完成時間、人工修改及常見錯誤。
- 第 2 日: 固定資料版本、prompt、輸出格式及安全規則。
- 第 3 至 5 日: 用 Sonnet 5 和 Sonnet 5.5 分別處理相同任務;若比較 Opus 5.5,要另行記錄模型定位及成本。
- 第 6 日: 由同一批審批人按同一份 rubric 評分,分類為事實錯誤、語氣、格式、遺漏及不應輸出的資料。
- 第 7 日: 以時間、token、成本、人工修訂和接受率作決策,並保留未通過的案例。
可以使用簡單表格:任務 ID|模型|輸入版本|耗時|tokens|估算成本|人工修改分鐘|錯誤類別|是否接受|備註。先定義「可接受」的門檻,再看哪個模型符合,而不是先選模型再調整標準。
資料、安全與遷移限制
官方列出 zero data retention 選項,不代表所有帳戶、方案或企業部署都會自動套用相同條款。IT 或法務團隊仍要核對合約、資料流、權限、保存期及供應商設定。個人資料、客戶機密、未公開財務資料及受版權保護的素材,都不應因為模型更新而跳過內部規則。
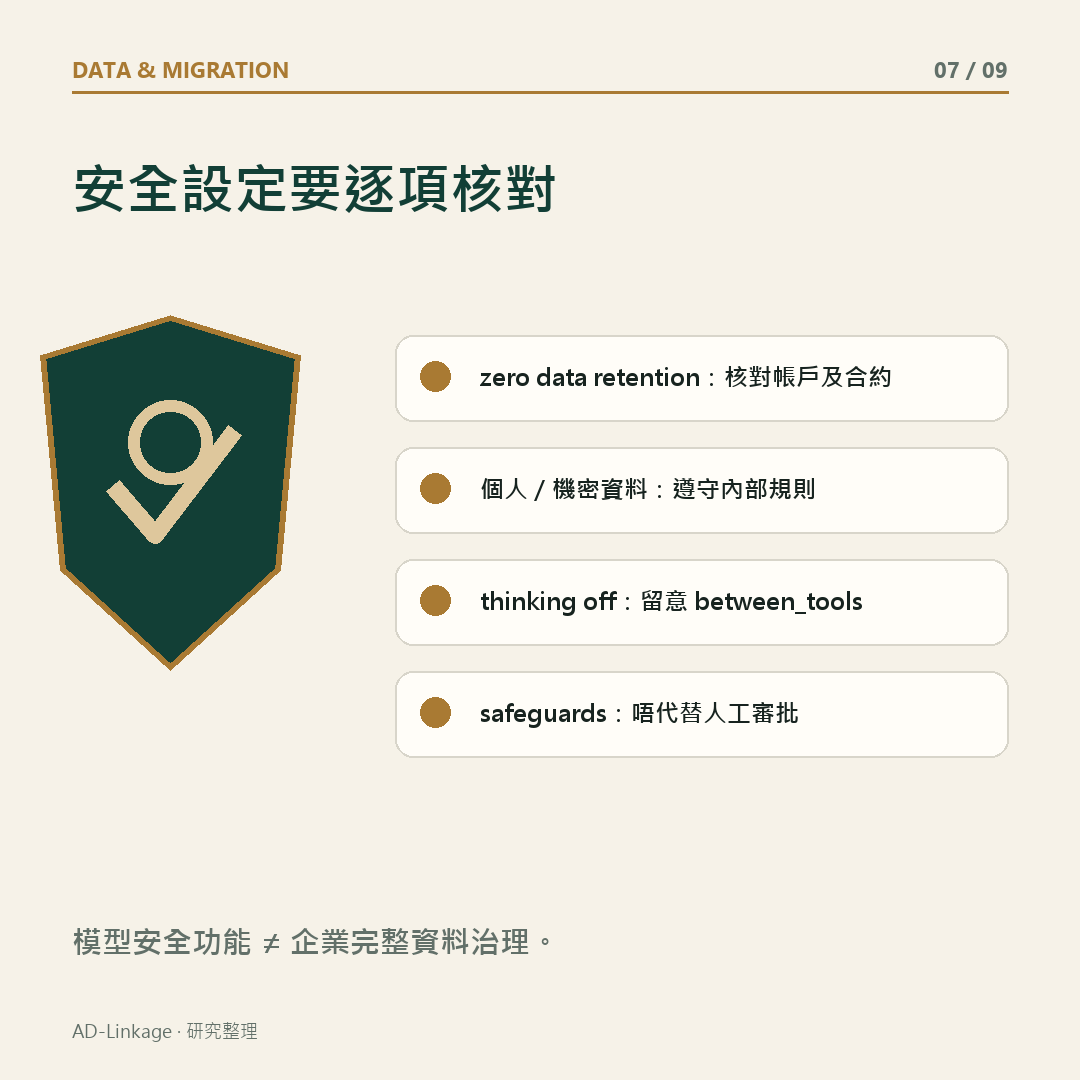
對已使用 thinking 設定的開發流程,Anthropic Platform Docs 的 Sonnet 5.5 migration guide 說明關閉 thinking 時要留意 between_tools 遷移設定。工程團隊應先在測試環境檢查工具呼叫、錯誤處理及輸出格式,再改動生產流程。
至於 cyber safeguards、fallback 和生物安全設定,官方描述的是模型層面的安全安排;它們不能代替企業自己的存取控制、人工審批、紀錄保存或事件處理程序。
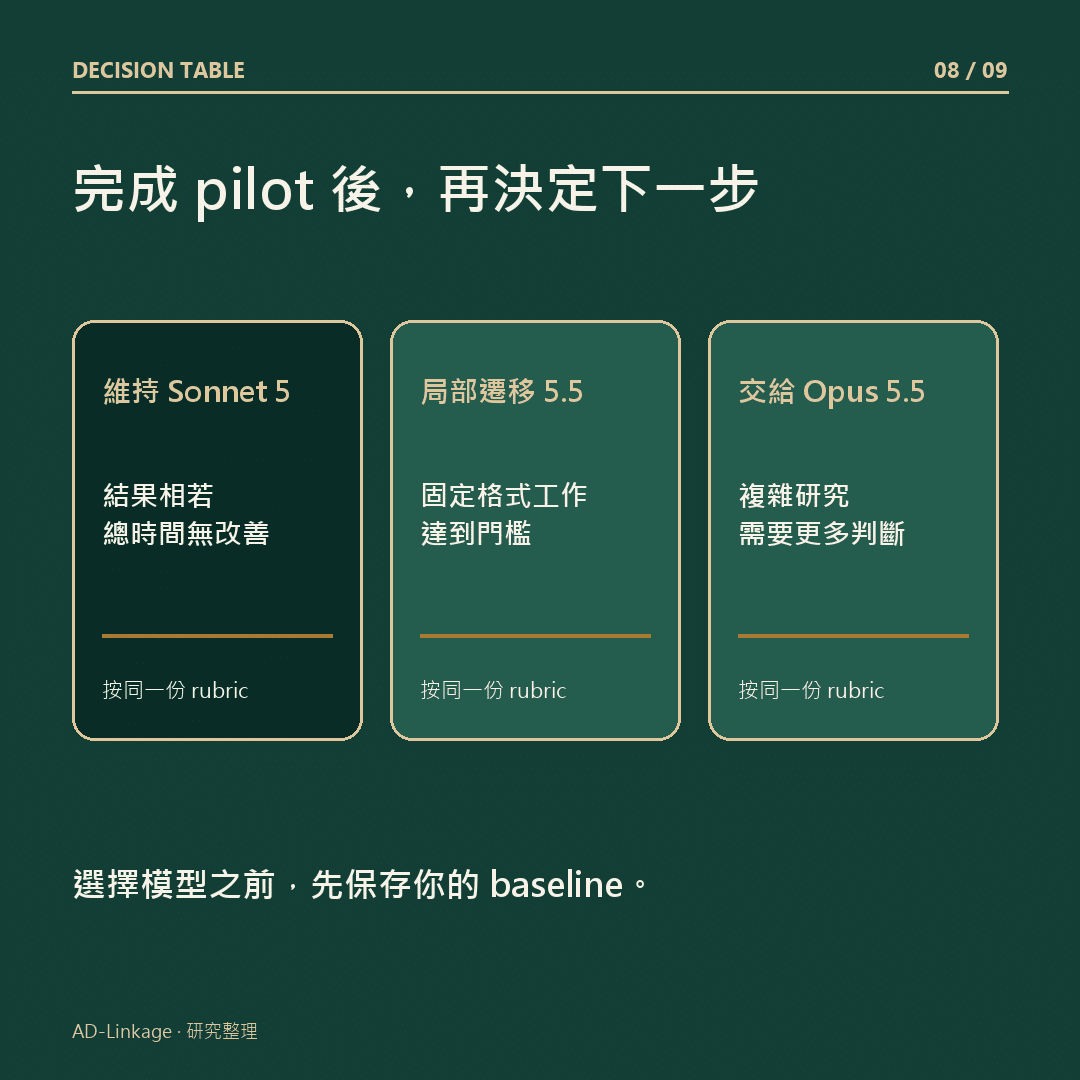
何時應維持、局部遷移或改用 Opus
完成 pilot 後,可以用三種結果整理下一步:
- 維持原有 Sonnet 5: 任務結果相若,但新模型未能改善總時間或人工修改;先保留目前流程,等待更完整證據。
- 局部遷移到 Sonnet 5.5: 日常文件、FAQ、簡報或有固定格式的工作達到既定門檻;只把通過測試的流程逐步切換。
- 把複雜任務交給 Opus 5.5: 工作需要更多開放式研究、長程規劃或細緻判斷;成本及審批要求要一併記錄。
這個決策表比「所有團隊直接升級」更容易追蹤,也讓日後換模型時保留可用的 baseline。
下一步:把模型放入可驗收流程
如果你想學習如何把 AI 模型放入真實的工作流程,PCPPMAI 可以作為學習 AI 應用、提示設計、資料整理及驗收方法的入口;如果企業需要先盤點流程、設計試點、接駁系統及建立驗收方法,則可查詢 AI 企業轉型體驗包。兩者的目的都是協助你把問題、資料、審批和結果連起來,並不代表任何特定模型一定適合你的公司。
CTA 連結核對提醒: 以上連結按發布時的 CMS 入口整理;課程名稱、日期及可用性仍應以各產品頁最新資料為準。本文沒有承諾課程提供 Claude Sonnet 5.5,也沒有承諾企業轉型結果。
來源及限制
- Anthropic:Introducing Claude Sonnet 5.5(官方日期:2026-09-28;查證:2026-09-29)
- Anthropic:Introducing Claude Opus 5.5(官方日期:2026-09-22;作定位比較)
- Anthropic Platform Docs:Sonnet 5.5 migration guide(查證:2026-09-29)
本文所引用的速度、成本及 benchmark 數字均屬官方資料;沒有獨立重做 benchmark,也沒有把香港帳戶可用性、企業合約條款或客戶結果當成已確認事項。