本文重點
TypeSafe AI 在 2026 年 9 月 15 日公布 Jev,將它定位為第一個公開的 System One Model。它的設計方向與一般聊天式大型語言模型不同:輸入一段 state 及幾條已經定義好的問題,輸出 typed decisions、probabilities 及 confidence,讓軟件可以直接作分流、評分、排序或升級處理。
這個方向對香港企業有吸引力,因為很多 AI 導入項目不是要模型寫一篇文章,而是要在客服、銷售、風險、審批或營運流程中回答一個窄而清楚的問題。不過,Jev 仍然是 2026 年 9 月的 early access 產品;官方速度、成本及 benchmark 數字是 TypeSafe 自家資料,不能直接當成任何企業環境的實測保證。
1. Jev 不是另一個聊天模型
一般 LLM 以文字生成為核心。即使要求它輸出 JSON,應用程式仍然要處理格式錯誤、漏欄位、字串解析和模型自行加入的內容。TypeSafe 對 Jev 的取向是相反的:由程式預先定義答案空間,模型只在這個結構內作判斷。
官方文件將 System One 描述為「讓軟件直接使用的快速、結構化決策模型」。Jev 接收文字、JSON object 或文字陣列,目前不支援圖片、音訊或影片。它不負責寫回覆、產生程式碼或解釋自己的推理;它的輸出是讓外層程式使用的答案及機率。
這裡的重點不是「模型一定正確」,而是把 AI 判斷收窄成可以檢查的介面。應用程式仍然要保留規則、權限、資料庫寫入和對外副作用,並由人決定哪些低信心結果必須升級。
2. 官方公布了甚麼能力?
Jev 目前有三種基本問題類型:
| 類型 | 典型問題 | 程式收到的結果 |
|---|---|---|
| Noul | 「這宗訊息是否要求退款?」 | 0 至 1 的 yes/no 機率 |
| Choice | 「應由哪一隊跟進?」 | 選項、各選項機率及 confidence |
| Score | 「客戶有多焦急?」 | 按 rubric 計算的分數、分布及 confidence |
三種問題可以在同一個 request 一起提出。官方文件表示,各問題會對同一個 state 獨立及並行評估;加入更多窄問題,不等於把前一條答案偷偷變成下一條的上下文。這種設計適合將一個大判斷拆成幾個可追蹤的小判斷。
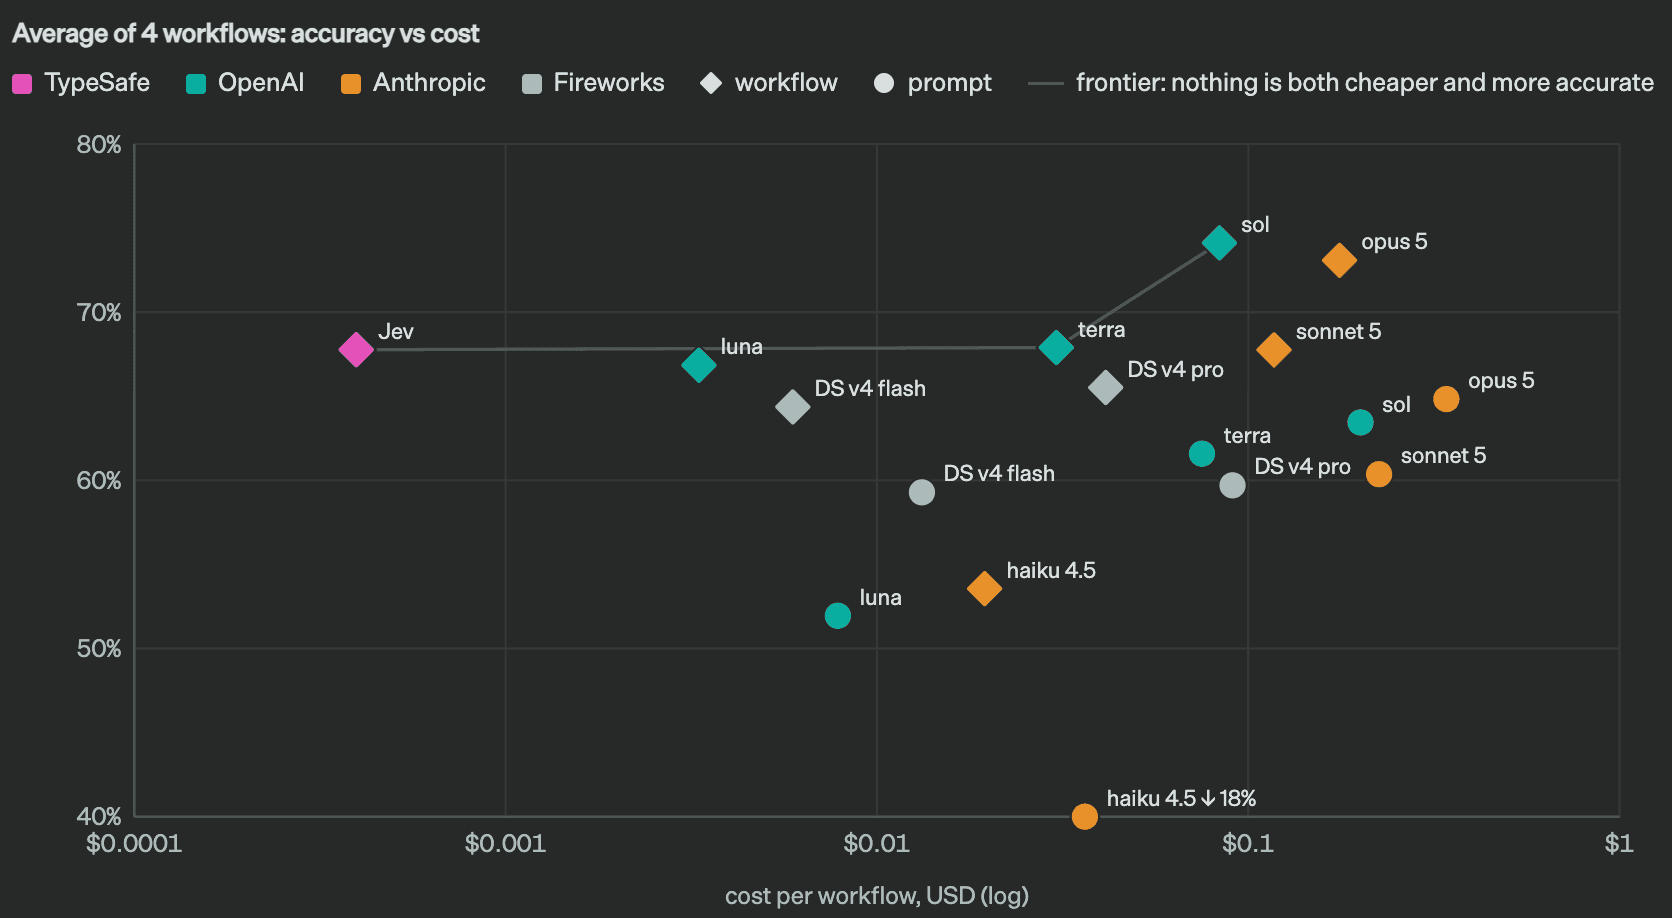
TypeSafe 官方新聞稿及首頁亦列出速度和成本比較。官方文章報告 Jev 的 end-to-end response time 約為 70 至 500ms,並以「$0.042/每百萬 input tokens」列示價格(該價格段落未標明幣種,採用前須向供應商確認);首頁用自家 workflows 顯示 193.6 倍速度及 444.6 倍成本差距。這些數字有三個限制:測試由 TypeSafe 設計、比較模型和 wrapper 會影響結果,而 Jev 仍在 early access。企業應以自己的資料、網絡、重試、快取和人工覆核成本重新測量。
3. Jev 實際怎樣幫手作判斷?
可以把 Jev 想像成放在企業工作流程中間的一個「判斷站」,而不是一個會自行處理所有事情的聊天機械人。它的工作只有一段:看清楚眼前資料,回答幾條預先寫好的問題,然後把結構化結果交回原本的系統。
整個流程可以用四步理解:
- 先給它要判斷的資料。 例如客戶訊息、訂單狀態、會員級別和適用的退款政策。這些資料就是官方所說的
state,即「今次要判斷的資料」,不是把整個公司的資料庫全部交出去。 - 再問幾條清楚的問題。 例如「應由哪一隊跟進?」「是否需要即時處理?」「資料是否足夠交給退款專員?」這些就是
questions,即「要模型回答的問題」。每條問題都應該有清楚的答案範圍。 - Jev 回傳判斷結果。 它不只回覆一段自由文字,而是按指定格式回傳選項、分數、機率和信心程度。例如:
team = billing、urgent = yes、confidence = high。 - 由原本的系統或人決定下一步。 系統可以按規則建立客服工單、通知值班同事或套用現有模板;低信心或高風險個案則交給人處理。Jev 本身不會替企業回覆客戶、批准退款或修改帳戶。
官方文件將可問的問題分成三種,名稱可以先不用記:
| 官方名稱 | 簡單理解 | 例子 |
|---|---|---|
| Noul | 是/不是的判斷 | 「這句話是否表示客戶要求退款?」 |
| Choice | 從指定選項中選一個 | 「應由 billing、technical 還是 account 團隊跟進?」 |
| Score | 按預先寫好的尺度評分 | 「客戶的迫切程度是 1 至 5 分中的哪一級?」 |
如果要由程式接駁,官方 quick start 使用 POST https://api.typesafe.ai/v1/systemone,並以 jev-latest 指定模型。技術上,程式會把上面所說的資料和問題送出,再讀取 Jev 的結構化答案;這只是官方介面示意,不是 AD-Linkage 的實測或客戶部署。API key、權限、重試、日誌、資料保留和敏感資料遮罩,仍然要由實施團隊設計。
一個具體案例:香港護膚網店收到 WhatsApp 查詢
假設一間香港護膚網店收到客戶訊息:「上星期買的精華用了兩日紅腫,可以退款嗎?今晚要出差,請盡快覆我。」這個例子不是要 Jev 代替客服寫一段長回覆,而是示範它如何先把訊息拆成幾個可以檢查的判斷。
第一步:系統只提供必要資料。 送給 Jev 的資料可以包括原文訊息、訂單是否存在、適用的退貨政策版本,以及客戶是否已上載相片。不需要把整個 CRM、所有歷史對話或未相關的個人資料一併送入去。這一小組資料就是今次的 state。
第二步:Jev 回答三條固定問題。 例如:「這是否退款要求?」「應交客服、退貨,還是產品安全同事?」「迫切程度是 1 至 5 哪一級?」問題的答案範圍在送出前已經寫好,所以系統知道要讀取甚麼欄位。
第三步:得到一組結構化結果。 以下數字只是方便理解的假設示例,不是 Jev 實測:
| 判斷項目 | 假設結果 | 代表甚麼 |
|---|---|---|
| 是否退款要求 | 是,機率 0.94 | 客戶明確問能否退款 |
| 應交哪一隊 | 產品安全同事,機率 0.81 | 訊息提到使用後紅腫,不能只按一般退款流程處理 |
| 迫切程度 | 5/5 | 客戶要求今晚前獲回覆 |
| 分流判斷的信心 | 中至高(文字化示例) | 這裡只描述「應交哪一隊」的判斷,並非整份結果的總分;仍要由公司的規則決定是否需要人工閱讀 |
第四步:由外層系統和人員接手。 公司可以按既定規則建立高優先個案、通知產品安全同事、暫停自動退款模板,前線只回覆已批准的收件確認,例如「已收到你的訊息,我們會由同事跟進」。Jev 不作醫療判斷、不批准退款,也不會自行向客戶承諾結果。
如果訂單資料欠缺、客戶沒有提供所需資料,或者信心低過公司預先設定的門檻,系統就直接轉交人員閱讀。這個案例展示的交付物,是一組可追蹤的結構化判斷,而不是一個已經自行完成的客服動作。
4. 例子:香港網店怎樣用 Jev 分流客服訊息?
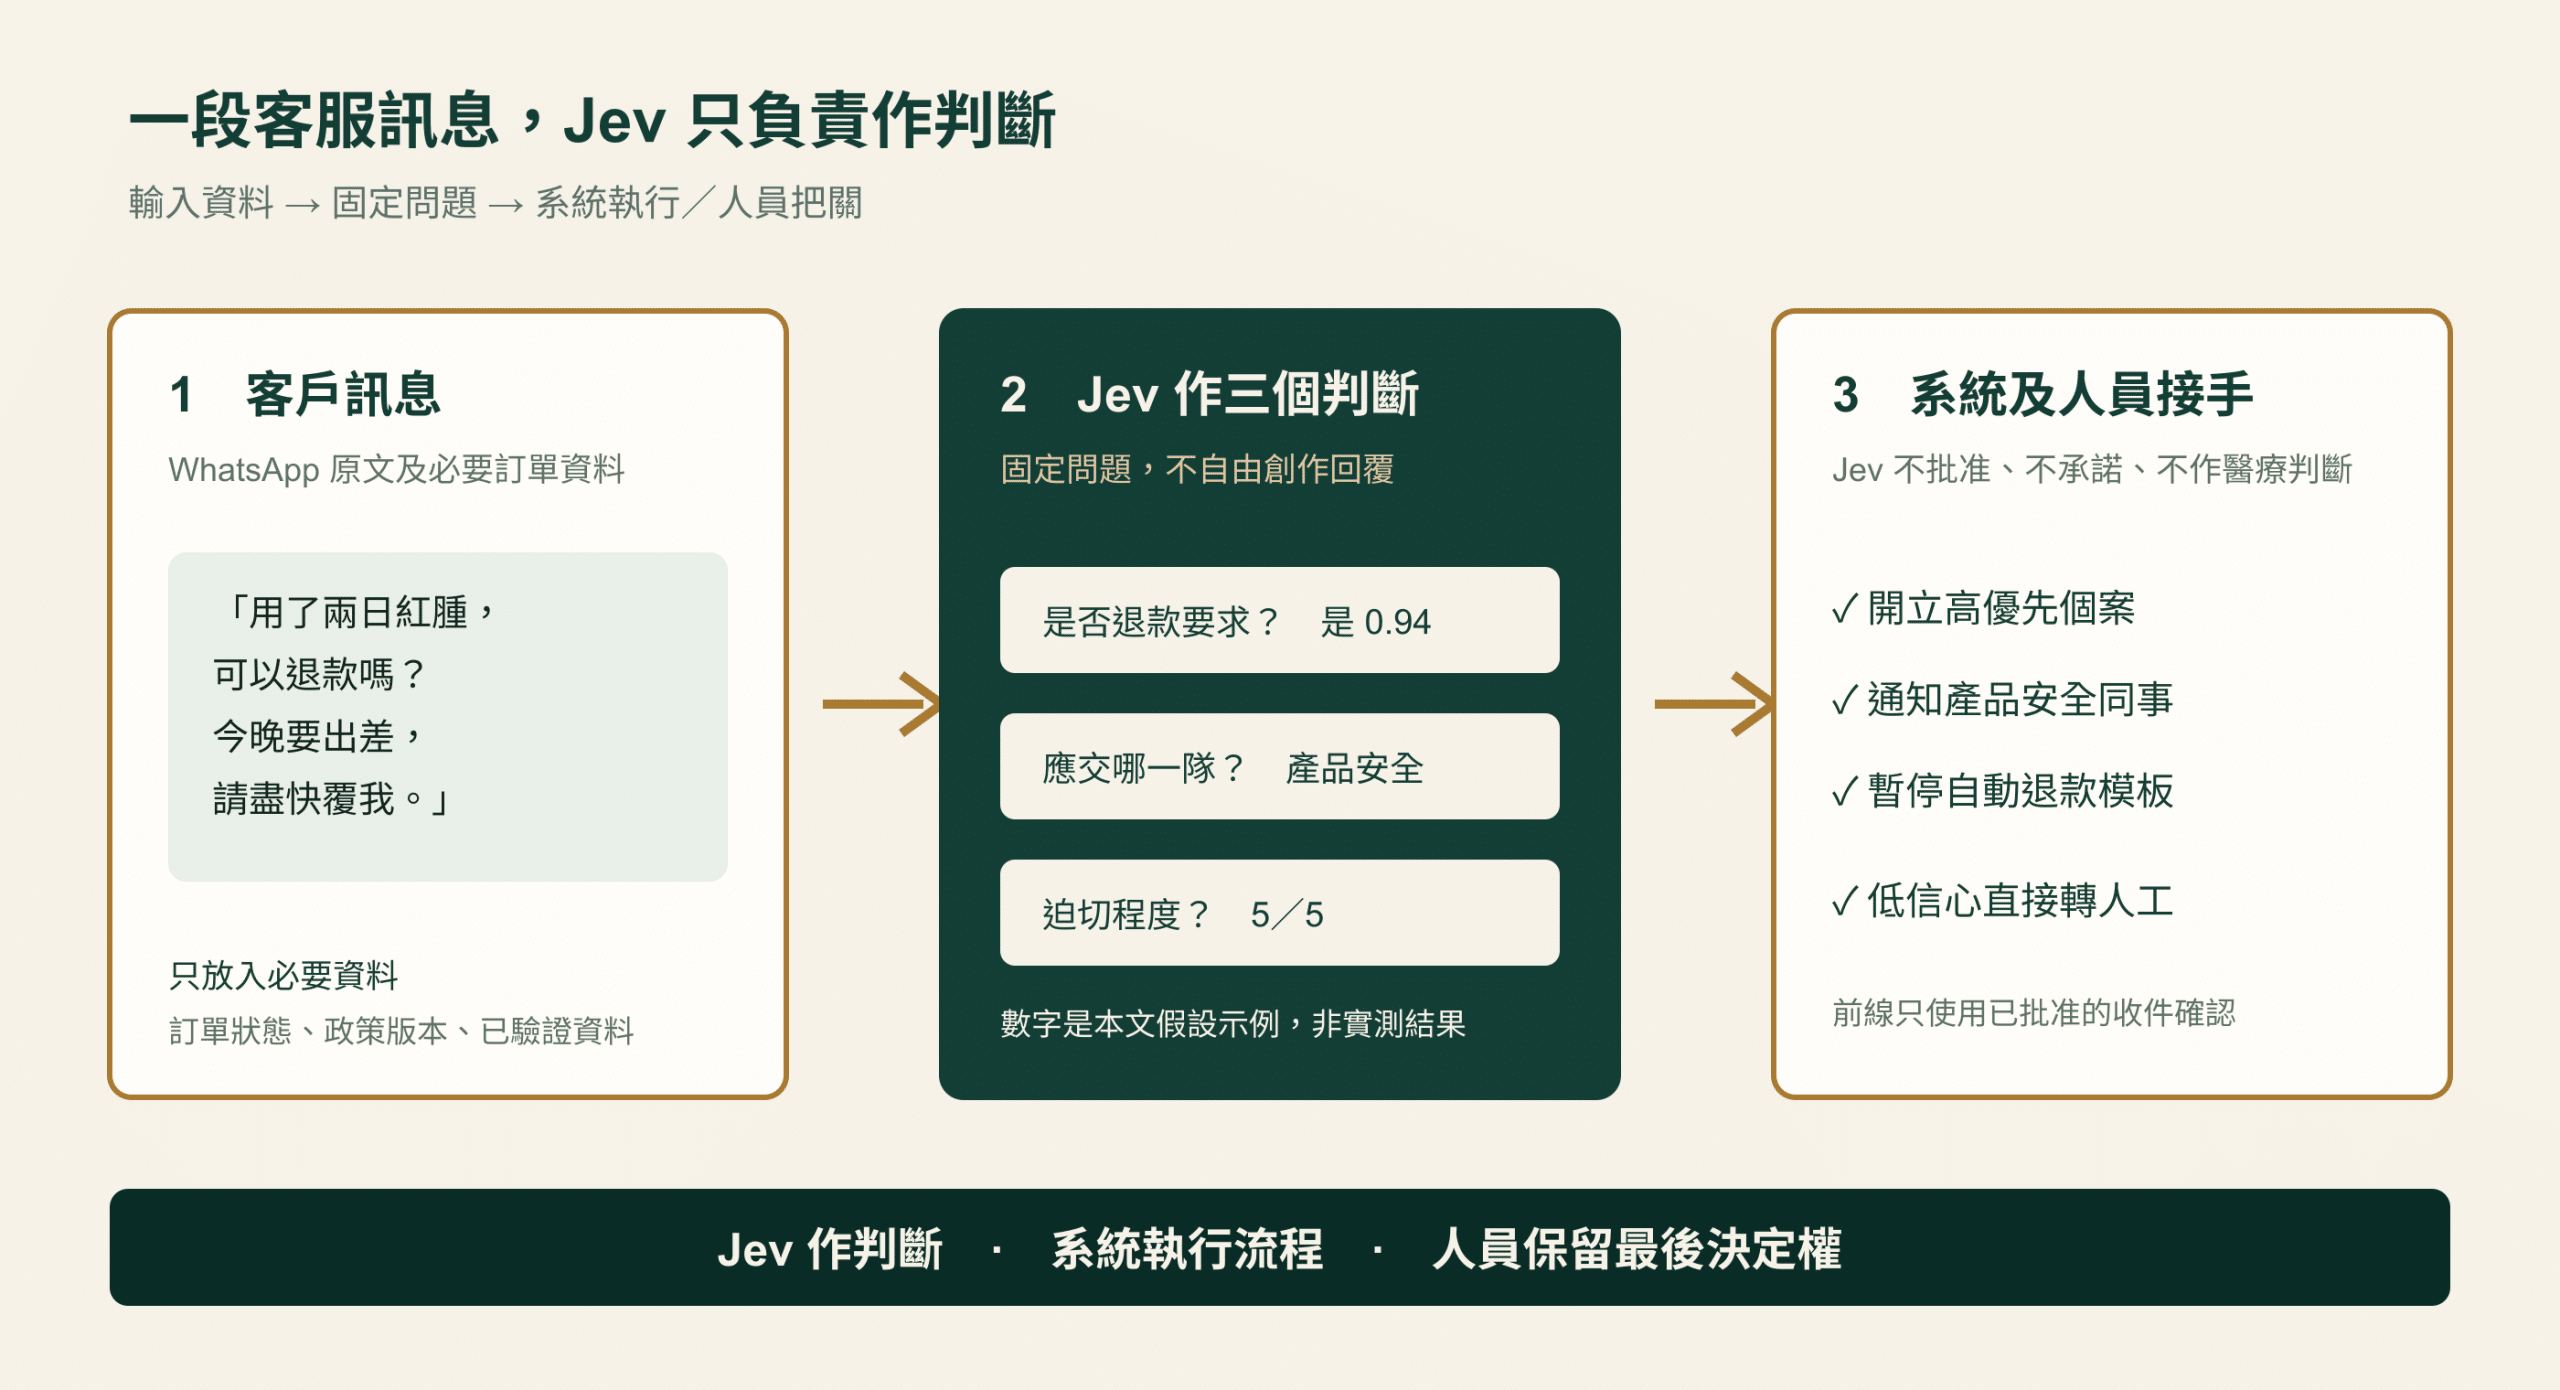
以下把上面的概念再壓縮成一張流程圖。圖中是本文為了解釋客服分流而繪製的示意,不是 Jev 官方畫面,也不代表 AD-Linkage 已完成這個部署。客戶仍然可以透過 WhatsApp、網站表單或電郵聯絡;Jev 只負責讀取訊息和作分類,現有客服系統及同事繼續負責實際跟進。
| 客戶說法 | Jev 幫手判斷 | 系統下一步 |
|---|---|---|
| 「我被扣款兩次,今日一定要處理。」 | 類別:付款/退款;迫切:是;信心:高 | 開立付款個案,通知值班同事;不會自動答應退款 |
| 「想知道包裹去到邊。」 | 類別:物流查詢;迫切:否;信心:高 | 從已核實的訂單資料套用物流查詢流程,提供追蹤連結 |
| 「你哋上次話會處理,但我而家都唔知點算。」 | 類別:未能確定;信心:低 | 不套用自動模板,轉交客服同事先閱讀再回覆 |
這張表的重點,是把三件事分開:
- Jev 做判斷: 它判斷訊息屬於哪一類、是否迫切,以及自己有多大把握。
- 系統做執行: 原有的工單、追蹤連結、通知和回覆模板,按公司規則運作。
- 人做把關: 涉及退款、帳戶權限、投訴或信心不足的個案,交給同事決定。
文中所說的「信心門檻」,意思很簡單:企業先訂一條最低要求;Jev 的信心低過這條要求,就交俾人處理。門檻不是 TypeSafe 替企業決定的標準,必須用自己的歷史個案測試後才設定。這樣做的目的,是避免模型分類看似合理,系統卻因此自動作出退款、改帳戶或向客戶作出未經批准的承諾。
所以,Jev 的交付不是「一個模型代替客服」,而是「在現有流程內增加一個可檢查的判斷步驟」。企業仍然保留資料權限、政策規則、對外回覆及最後決定權。
5. Jev、LLM 和 agent 應該怎樣分工?
| 工作 | 較合適的工具方向 | 原因 |
|---|---|---|
| 寫一封有語氣的客戶回覆 | LLM 或人工模板 | 需要自然語言及上下文表達 |
| 從一宗工單判斷隊伍、優先級、風險 | Jev/System One 類模型 | 答案空間可預先定義,結果可分流 |
| 連續計劃、呼叫工具、修改檔案 | 受限制的 workflow 或 agent | 需要明確權限、狀態和副作用控制 |
| 最終退款、封鎖帳戶、法律或人事決定 | 人工及正式政策 | 不能只靠模型 confidence 作批准 |
Jev 官方文件特別強調「code keeps control」:程式擁有控制流程,模型只在需要 common-sense judgment 的位置出現。這和把一個聊天模型放進無限 agent loop,是兩種不同的工程取向。
6. 「calibrated confidence」不等於保證正確
TypeSafe 將 RLCD(Reinforcement Learning for Calibrated Decisions)描述為訓練及校準決策機率的方法。官方文件亦補充,calibration 是在一組預測上衡量,並不保證每一個個別答案都正確。
所以企業不應把 confidence: 0.92 直接翻譯成「92% 一定正確」。正確做法是用自己的歷史資料畫出 confidence 與 accuracy 的關係,再決定 0.8、0.9 或其他門檻;高風險流程可以要求人工覆核,低風險流程才逐步放寬自動化範圍。
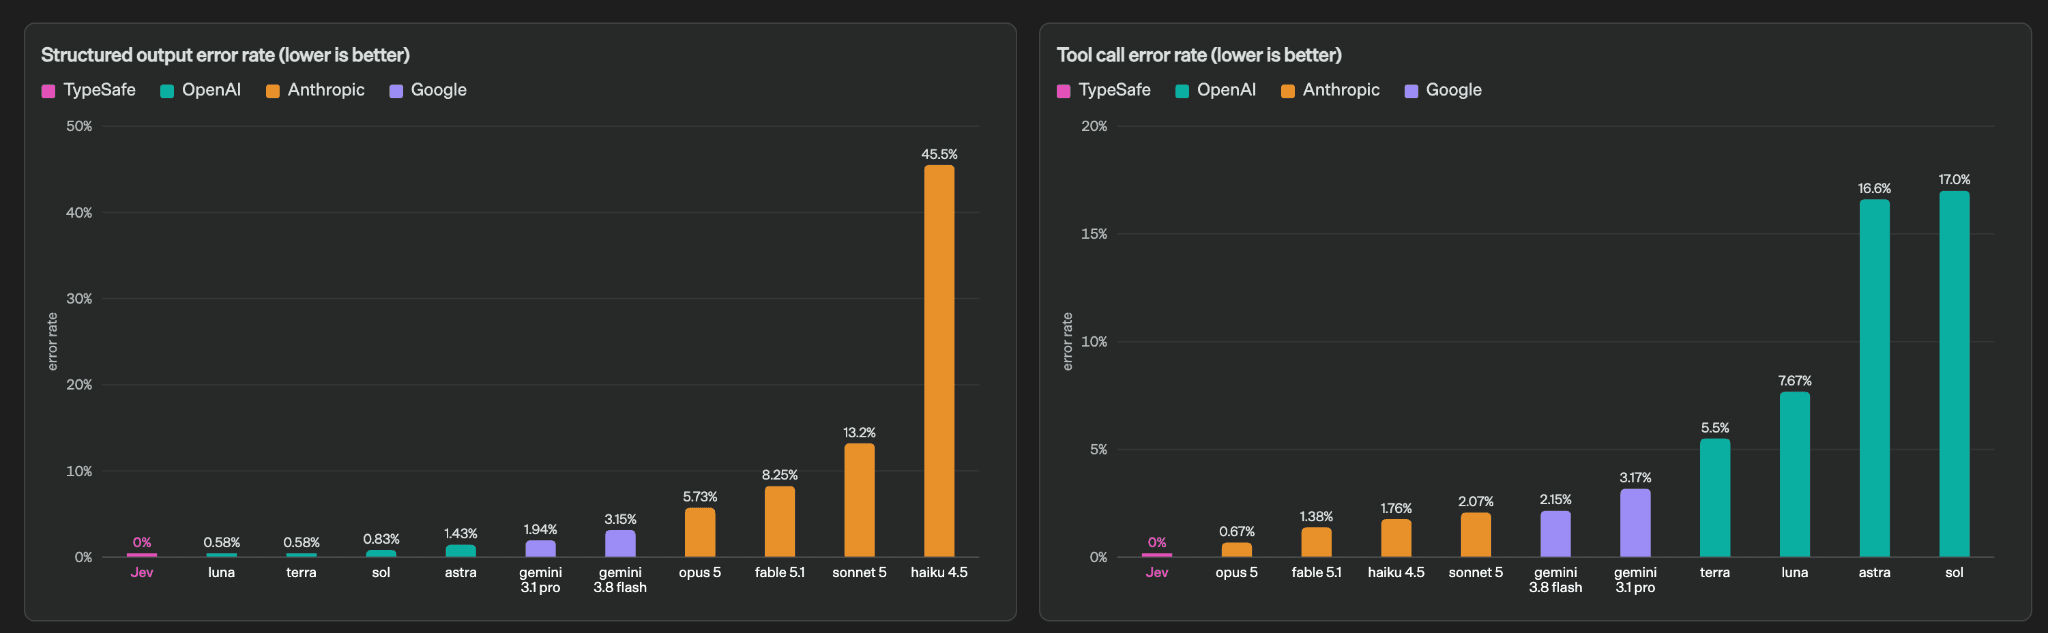
官方所說的「zero hallucinations」主要是指輸出被限制在預先定義的 schema,避免模型產生不在型別內的自由文字。它不代表 Jev 不會誤判、資料不會過期、政策不會寫錯,亦不代表應用程式的後續動作一定安全。
7. 現階段採用前要核對甚麼?
- 輸入界線: 目前官方文件寫明只支援文字、JSON object 和文字陣列,未支援圖片、音訊、影片。
- 可用性: Jev 仍是 early access;帳戶申請、地區可用性、rate limit、服務狀態及 SLA 要在正式採用前確認。
- 成本: 官方價格可能改變;把 token、網絡、重試、快取、人工審核及失敗處理一起計算。
- 資料保護: 對客服、財務或人事資料先做資料分類、遮罩、保留期限及供應商審查。
- 評估: 以香港團隊自己的匿名歷史案例測試分類、分數、confidence、誤判及升級率;不要只看官方 demo。
- 撤回機制: 每個會改變帳戶、付款、權限或對外溝通的動作,都要有明確的 human-in-the-loop 和 rollback。
8. 對香港團隊的實際意義
Jev 最值得觀察的地方,是它把 AI 從「替人寫東西」拉到「讓現有軟件多一層可量度的判斷」。如果企業已有 CRM、客服、審批或營運系統,下一個問題不是立即換模型,而是先找出一個低風險、可量度、答案空間清楚的節點,例如工單分流、文件完整性檢查、線索優先級或內部風險旗標。
下一步:按你的目標選擇合適入口
如果你想將這篇文章的判斷框架連接到自己的學習或業務需要,可以從以下方向開始:
以上 CTA 只代表不同學習或評估入口,不代表 Jev 已經是任何一個課程或服務的指定工具,也不代表任何部署結果或成本節省已獲保證;實際方案仍要按現有系統、資料及目標評估。
結語:先把問題問窄,再決定哪裡值得自動化
Jev 的新意不是「另一個更快的聊天模型」,而是嘗試建立一種讓軟件直接消費 AI 判斷的介面:問題先定義、答案有型別、機率和 confidence 一起返回,程式保留流程和副作用控制。
這個方向是否適合你的企業,要由真實案例驗證。先挑一個低風險流程,寫清楚 state、questions、threshold、人工升級條件和成功指標,再比較 Jev、現有 LLM、傳統規則和人工處理。完成這個小範圍驗證,才有足夠資料決定是否擴大到更高風險的業務環節。
資料來源與核對範圍
- TypeSafe AI:Introducing System One Models & Jev(2026-09-15)
- TypeSafe AI 官方首頁
- TypeSafe 文件:Introduction
- TypeSafe 文件:System One
- TypeSafe 文件:Quick start
- TypeSafe 文件:How to build with TypeSafe
- TypeSafe 文件:HTTP API reference
本文資料於 2026-09-22 核對。官方 benchmark、速度、價格和 early-access 狀態均按 TypeSafe 自己的頁面及文件記錄;本文沒有進行 Jev API 實測,亦不是獨立性能、法律或安全認證。


