本文重點
開場:一位飲食業朋友問「Token 係啲咩?」1. Token 的技術定義:AI 讀取及產生內容的計量單位2. Input、output、total:一個請求通常有三個數字3. Token、算力及電力:有關,但不是同一樣東西4. Token 多,不代表模型勁;Token 少,也不代表答案好5. 中間層為甚麼可能令有效質量被稀釋?6. 用餐飲業理解:張單、廚師、侍應與店長7. 一套可以重做的 Token 與質量驗收方法8. 企業實際上應該問的五條問題9. 對企業導入 AI 的實際啟示10. 下一步:由一個流程開始,建立可驗收的 AI 工作方法參考資料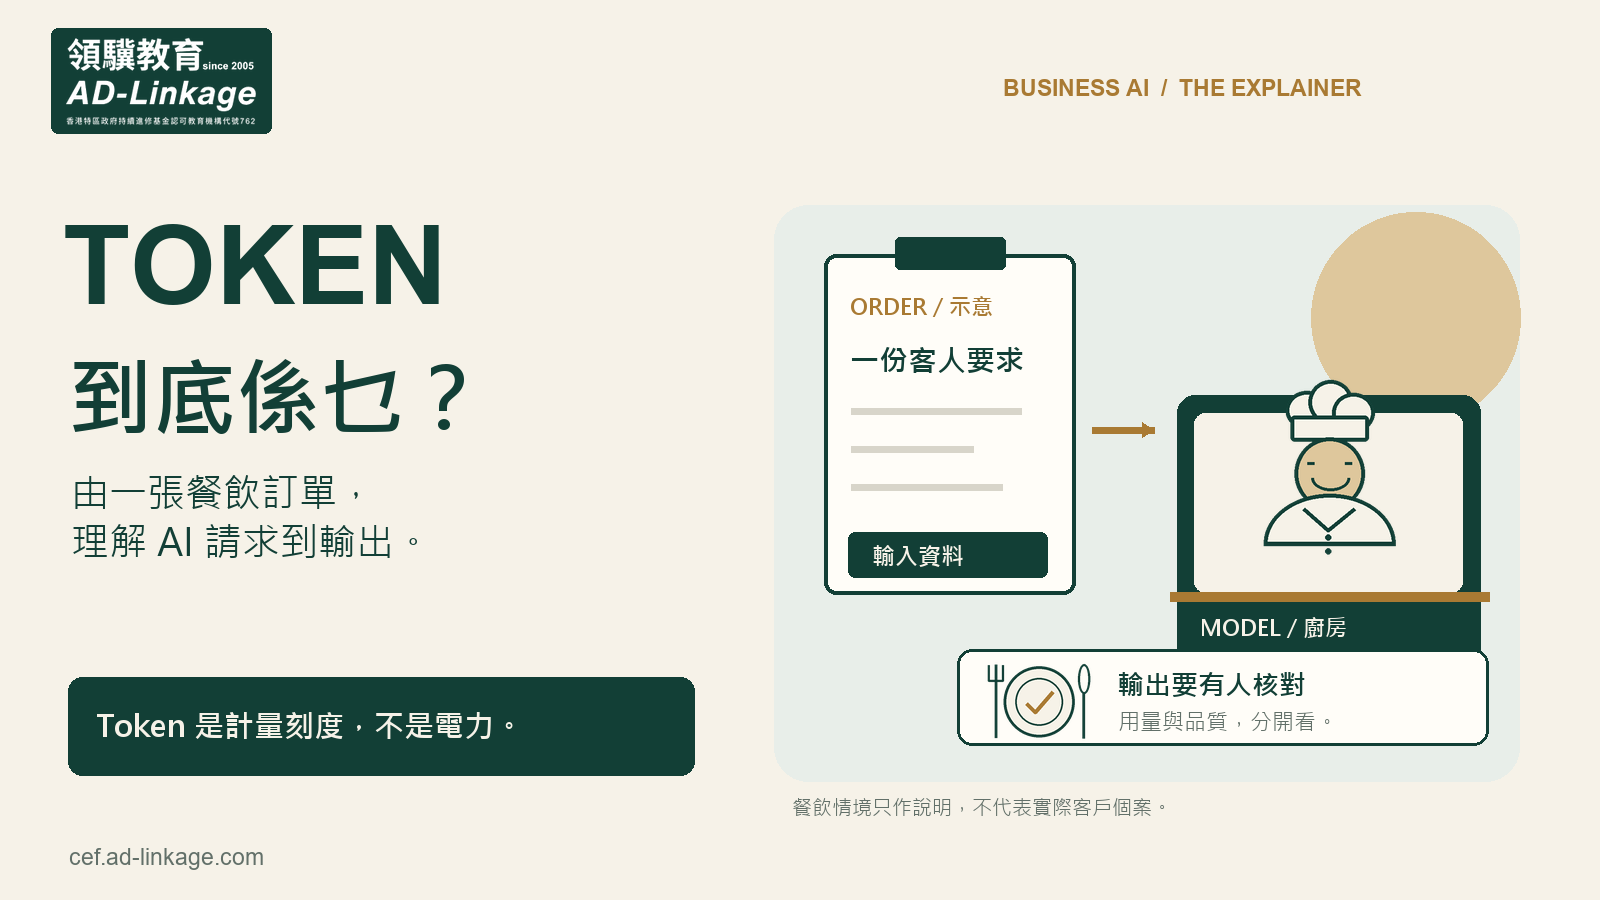
文中餐飲流程、數字及測試表格是說明例子;不代表 AD-Linkage 已經替任何客戶完成該項量度。
開場:一位飲食業朋友問「Token 係啲咩?」
早前同一位做飲食業的朋友傾計,佢問我:「成日聽人講 AI token,究竟 token 係啲咩?係咪即係買算力?」
呢個問題好實際。因為「token」聽落似一種可以買、可以用、可以消耗的東西,但佢又冇外形、冇重量,唔似一杯咖啡、一部電腦或者一度電。對企業來講,真正要明白的唔係背熟一個術語,而係知道:你付費買緊的是甚麼使用量?模型實際處理了甚麼資料?中間有冇一層系統改變了請求?最後點樣判斷輸出有冇價值?
本文會由這個日常問題出發,分清 token、算力、電力、模型質量及 gateway 的關係,最後用餐飲業例子示範一套可以重做、可以驗收的記錄方法。
1. Token 的技術定義:AI 讀取及產生內容的計量單位
對語言模型而言,文字唔係一次過以「一句」或「一個字」送入系統。模型會先用 tokenizer 將文字切成一串 token。Token 可以代表一個完整字、半個字、標點、空格或常見字詞片段,實際切法視乎語言及模型的 tokenizer。
所以 token 唔等於中文字數,亦唔等於字元數。英文一個常見短字可能被切成一個或幾個 token;中文、數字、網址、程式碼和混合語言,也可能有完全不同的切法。同一段內容交畀不同模型,token 數量可以不同。
Token 最有用的理解方式,是「模型處理內容時的計量刻度」。它讓服務供應商可以記錄請求大小、輸出長度、上下文使用量及相應費用。這個刻度是軟件計量,不是一粒可以從一部機器倒出來的實體材料。
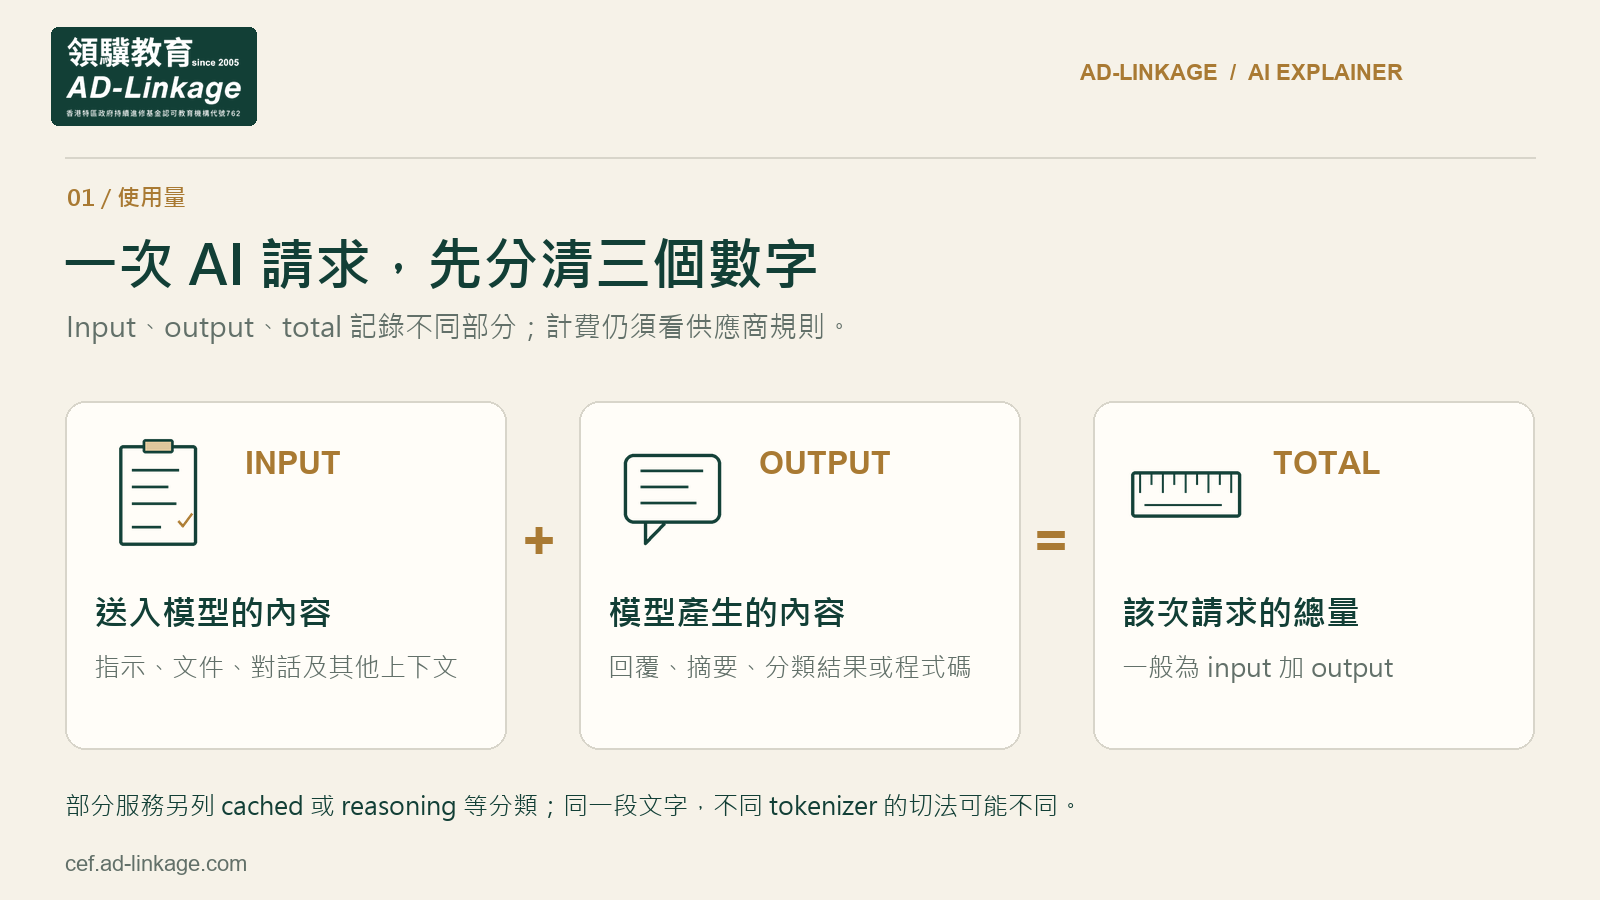
2. Input、output、total:一個請求通常有三個數字
企業談成本時,最少要分開以下三項:
| 名稱 | 意思 | 例子 |
|---|---|---|
| Input tokens | 送入模型的指示、文件、對話歷史、工具結果及其他上下文 | 你提供的菜單、營業規則及客人問題 |
| Output tokens | 模型回覆、摘要、分類結果或程式碼的長度 | 模型寫出的回覆或建議 |
| Total tokens | 供應商回報的該次總量;通常涉及 input 及 output,推理等分類以該 API 的定義為準 | 一次完整處理的總量 |
一個回覆寫得很長,output tokens 會上升;你每次都把整份政策文件連同新問題重送,input tokens 會上升;對話不斷累積,total tokens 也可能逐步增加。實際計費方式由供應商、模型、地區、輸入/輸出類別、快取及套餐條款決定,不能只見到一個 token 數字就推定金額。
核對用量時,亦要避免重複相加:cached tokens 或 reasoning/thinking tokens 可能已包含在 input 或 output 的分類內,亦可能由 API 另列。應先讀該供應商的 usage 欄位定義,再計算成本;不能一律把每個數字都加進 total。
此外,token 數量亦受上下文上限影響。當輸入太長,系統可能拒絕請求、要求縮短、截取較早內容,或者由中間層先摘要。每一種處理都會影響結果,應在記錄中分開寫明。
3. Token、算力及電力:有關,但不是同一樣東西
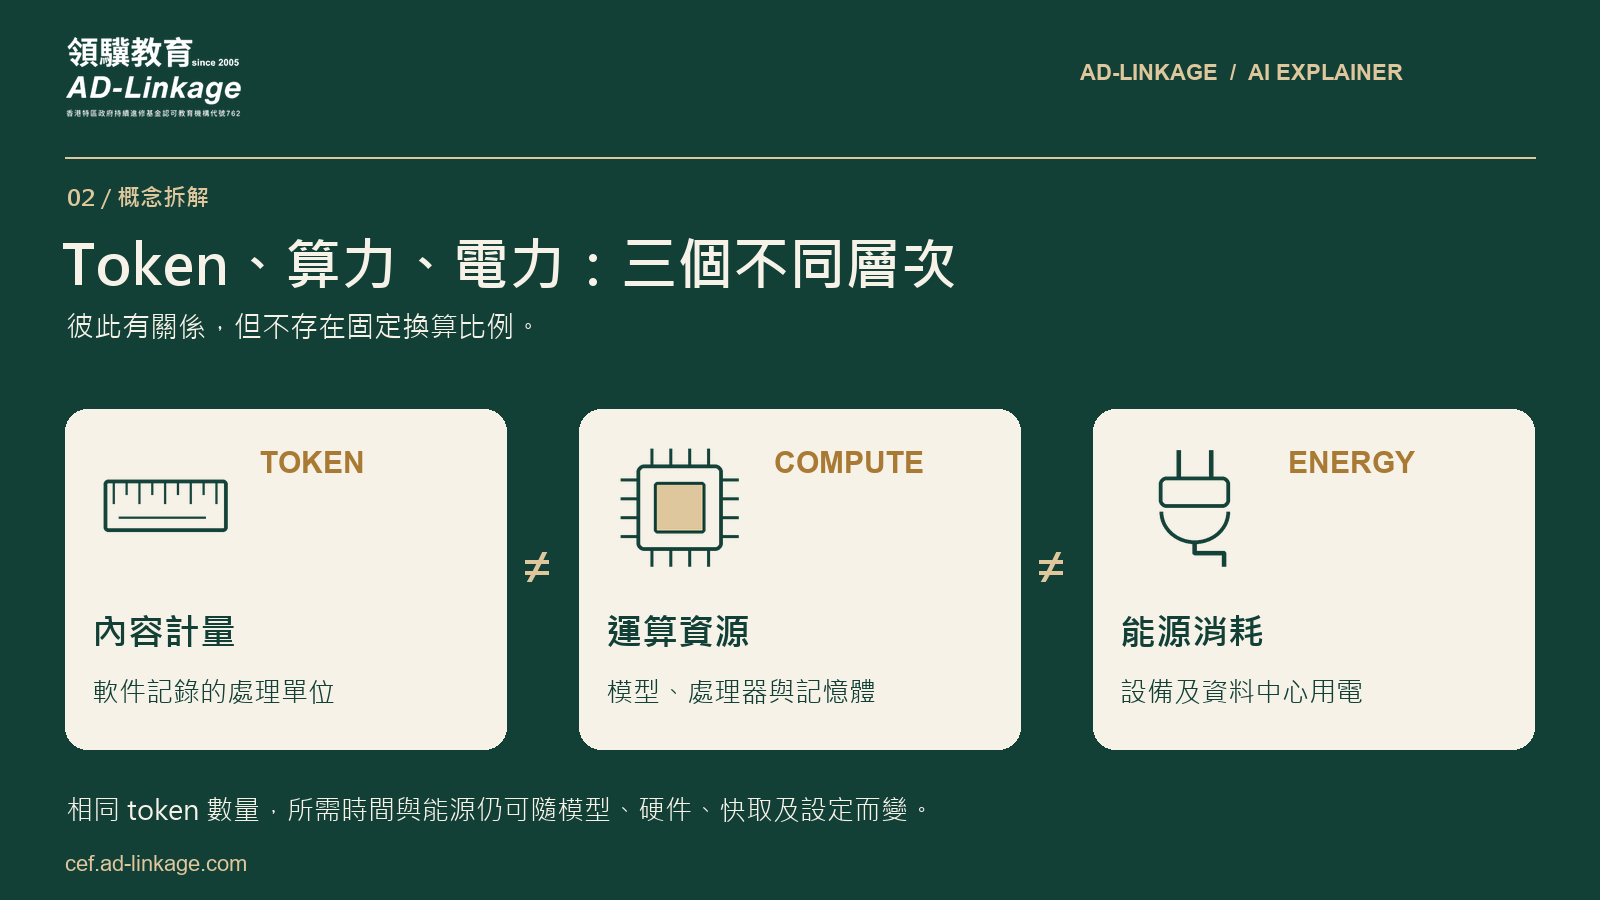
朋友話 token 似「算力」,我明白點解會有呢個感覺。模型要處理更多 token,通常需要更多運算、記憶體及時間;資料中心亦會消耗電力。因此,token 可以作為企業估算 AI 使用量的其中一個指標。
但三者不能畫上等號:
- Token 是軟件層面的內容計量單位。
- 算力 是模型執行所需的運算能力,例如處理器、記憶體及加速器的工作量。
- 電力 是資料中心及裝置運作的能源消耗。
相同 token 數量,在不同模型、硬件、批次方式、快取、網絡路由及服務設定下,所需時間和能源可以不同。反過來,相同電力消耗,也未必代表處理了相同數量或相同難度的 token。因此,對外解釋時可以說 token 是「AI 使用量的刻度」,算力和電力是背後支撐服務的資源;不要把 token 宣稱成一度電或者一份固定算力。
4. Token 多,不代表模型勁;Token 少,也不代表答案好
Token 主要反映內容長度及處理量,唔係能力評分。一個模型用 500 個 token 寫出流暢但錯誤的政策摘要,另一個模型用 250 個 token 指出關鍵限制,後者可能更有用。評估質量要睇任務是否完成、資料是否正確、引用是否可追溯、人工修改需要幾多時間,以及錯誤的代價。
影響輸出質量的因素通常包括:
- 模型能力及版本:不同模型在推理、長文、中文、程式碼、工具使用及安全處理方面可能有差異。
- 輸入資料:資料是否完整、版本是否正確、來源是否可信,往往比 prompt 寫得花巧更重要。
- 上下文安排:太多無關資料會遮蓋真正的要求;缺少必要條件,模型只可以猜。
- 任務及驗收標準:如果只要求「寫得專業」,就很難判斷結果好不好;如果有格式、來源、日期及錯誤分類,才可以比較。
- 人工把關:價格、合約、客戶承諾、合規內容及對外發布,都需要指定人士核對。
因此,談「質量」時,本文用的是輸出質量/質素,即結果是否準確、完整、可追溯及適合工作用途;不是物理學上的「質量」或重量。
5. 中間層為甚麼可能令有效質量被稀釋?
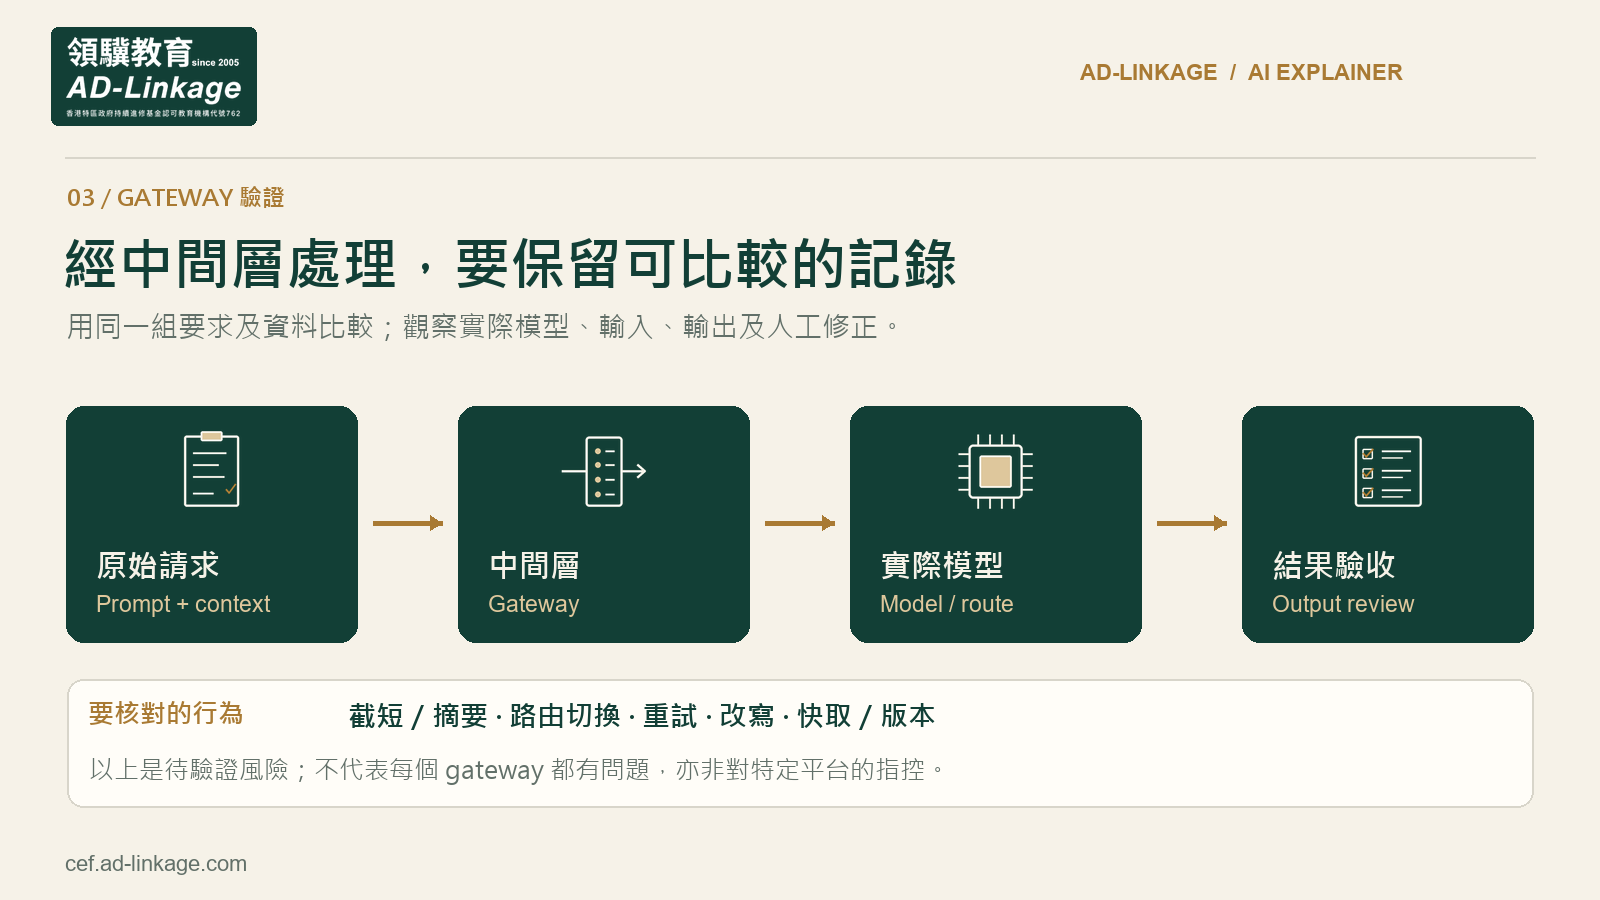
企業未必直接連接模型供應商,可能經過 AI gateway、中轉站、代理平台、工作流工具或自建 API 層。中間層本身沒有必然問題,佢可以提供權限、記錄、成本控制、模型切換及安全規則;問題在於,如果它的實際行為不透明,使用者會難以知道模型收到了甚麼及回覆怎樣產生。
需要驗證的風險包括:
- 上下文被截短或摘要:長文件未完整送入,關鍵條件可能消失。
- 模型路由改變:設定寫的是某一模型,實際可能因故障、配額或成本而轉用另一模型。
- 重試及重複計量:同一請求失敗後重試,成本、延遲及結果差異沒有被清楚記錄。
- 輸入或輸出被改寫:代理層加入提示、刪除欄位、改變格式或先做翻譯。
- 快取及版本不明:回覆可能來自舊資料或不同的 system prompt,而使用者未被告知。
- 不可追溯的「灌水」:如果把額外文字、無關上下文或重複步驟計入使用量,卻不能解釋它對結果有何幫助,企業便要問這些 token 是否真的增加了有效資訊。
以上是可測試的風險,唔係對任何特定平台的指控。要判斷有冇「稀釋」,不能只看賬單;要把原始請求、實際路由、token 記錄、延遲、錯誤及人工修正放在一起比較。
6. 用餐飲業理解:張單、廚師、侍應與店長
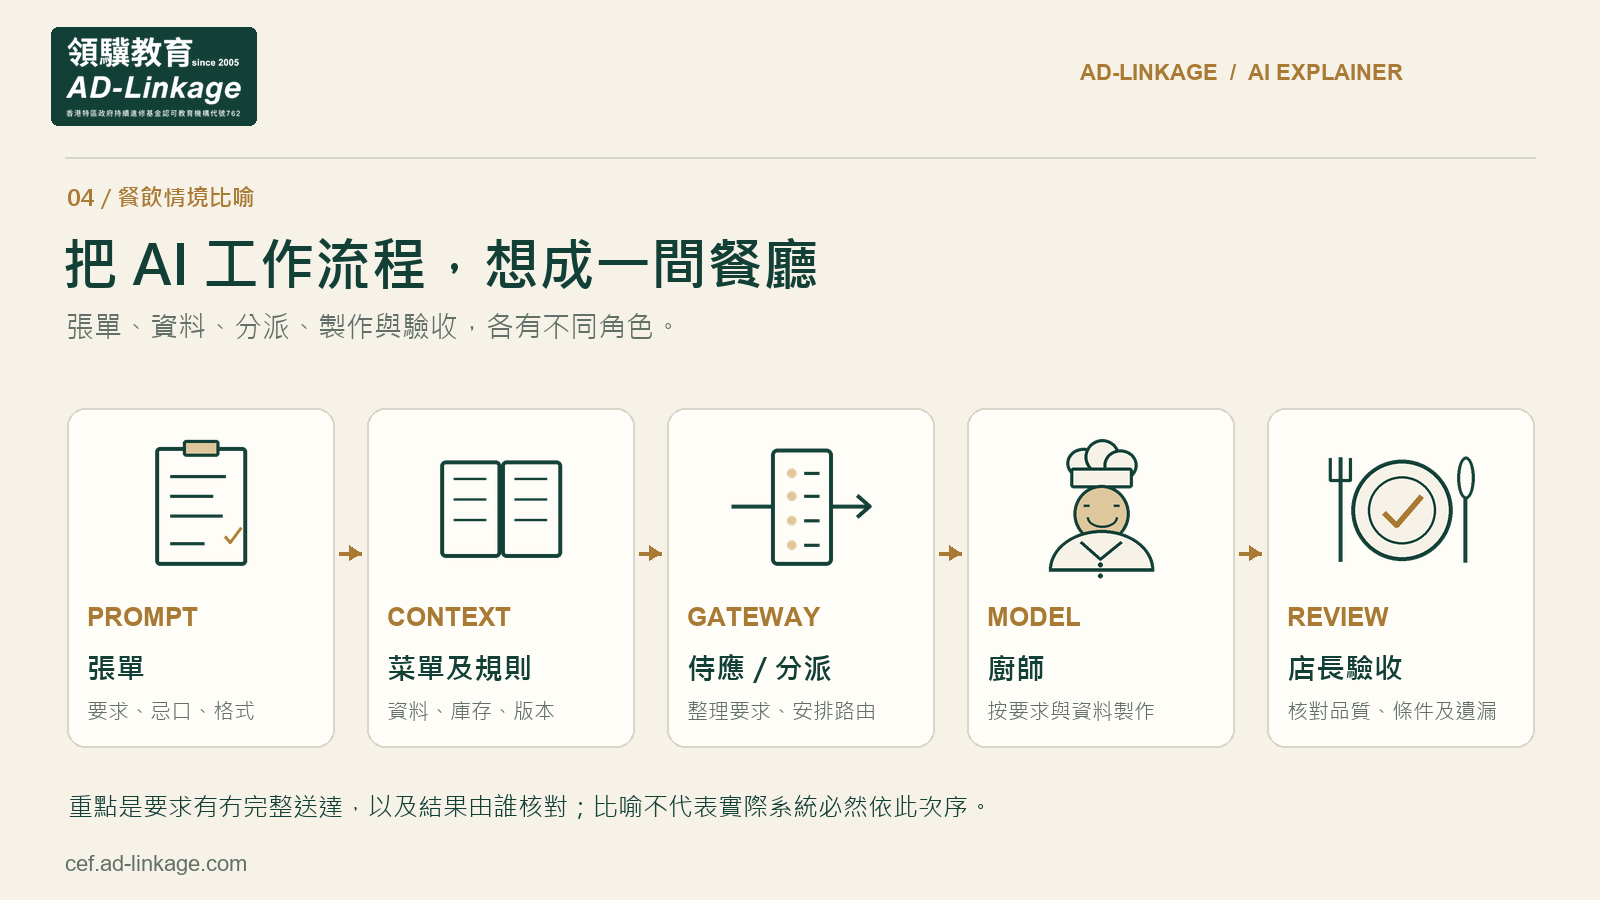
可以用一間餐廳的流程來比喻:
- Prompt 像客人的張單:想要甚麼、份量、忌口及交付格式。
- Context 像菜單、食材庫存、當日供應及店內規則:沒有這些資料,廚師只可以估。
- Model 像廚師:不同廚師有不同手藝、速度及處理複雜訂單的能力。
- Gateway/中轉層 像侍應或外賣平台:可以整理張單、檢查付款、分派廚房,但亦可能漏寫忌口、轉錯廚房或把訂單改成另一種格式。
- 人工覆核 像店長試味及出餐前檢查:確認菜式、份量、禁忌及客人真正收到的內容。
如果客人只收到一碗湯,不能只問廚師用了幾多粒米;要知道原本張單寫了甚麼、廚房收到甚麼、誰改過內容、最後由誰驗收。AI 工作流程也是一樣。
7. 一套可以重做的 Token 與質量驗收方法
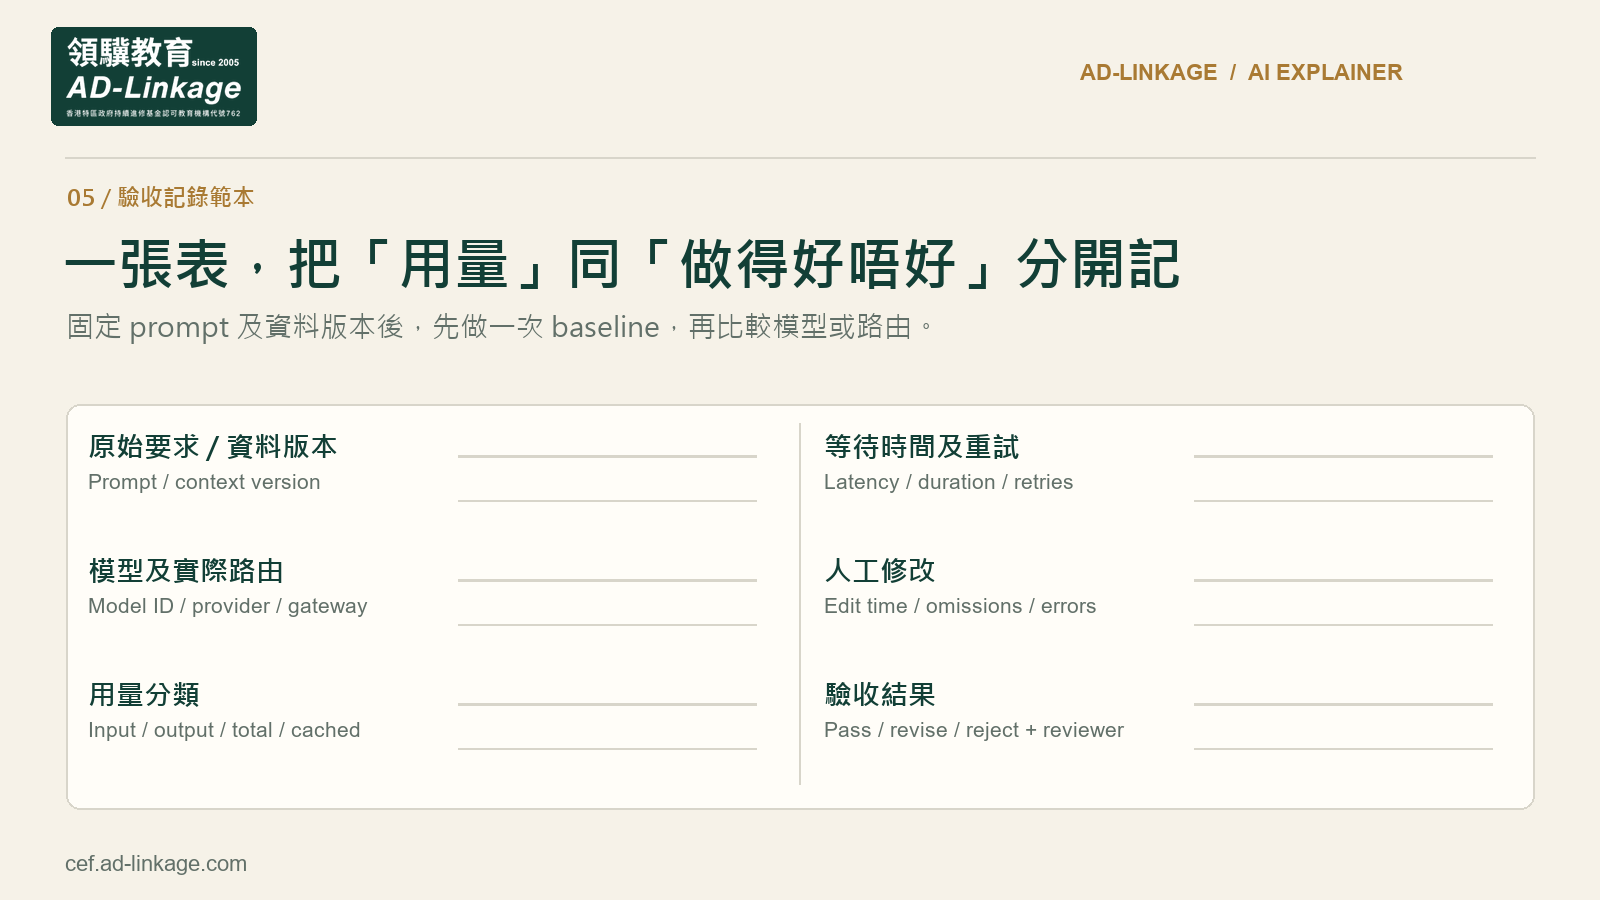
企業可以先選一個低風險、重複性高的流程做試點,例如把公開產品資料整理成內部 FAQ。每次測試記錄以下欄位:
| 欄位 | 要記錄甚麼 | 用來回答的問題 |
|---|---|---|
| 原始 prompt | 版本、日期、操作者及輸出格式 | 每次是否真的用同一個要求? |
| Context 版本 | 文件名稱、版本、頁數、更新日期及是否完整 | 模型實際得到哪一份資料? |
| Model / route | 模型 ID、供應商、gateway 及 fallback 設定 | 是否由同一條路由處理? |
| Token breakdown | input、output、total、cached 或其他可見分類 | 使用量在哪一部分增加? |
| Timing | 首字延遲、總時間、重試次數及錯誤 | 慢是模型、網絡還是重試造成? |
| Output review | 正確、遺漏、無根據、格式錯誤及敏感資料風險 | 結果是否符合工作標準? |
| Human effort | 修改分鐘數、退回次數及接手原因 | 是否真的減少人手? |
| Acceptance | 通過、需修改、拒絕;由誰及何時決定 | 能否在不同日期重做及比較? |
可以先用同一組 prompt 和同一份資料,分別直接呼叫模型及經 gateway 呼叫,再比較:輸入是否一致、model ID 是否一致、答案是否遺漏條件、總 token 是否異常、人工修改時間有冇上升。若 gateway 有摘要或路由切換,要求它保留可讀的事件記錄及版本資料,否則企業無法驗收。
8. 企業實際上應該問的五條問題
當供應商說「token 很便宜」或「可以無限用」時,管理者可以問:
- 計費是按 input、output、total,還是另有套餐及最低用量?
- 我可以看到每次請求使用的模型 ID、token breakdown、重試及 fallback 嗎?
- 長文件超過上下文上限時,系統會拒絕、截短、摘要,還是自動轉模型?
- gateway 會否加入 system prompt、保存資料、改寫內容或把資料送到其他地區?
- 我們用甚麼 rubric 判斷答案可接受?錯誤由誰覆核?
如果答不出以上問題,未必代表服務不能用,但代表企業仍未有足夠資料作風險及成本判斷。先用低風險資料做小型測試,通常比一次過把所有內部文件送入系統更容易控制。
9. 對企業導入 AI 的實際啟示
Token 令 AI 使用量有一個可以記錄的刻度,但真正的管理工作仍然是把資料、模型、權限、路由及人工驗收串起來。企業應把「用得幾多」和「做得幾好」分開量度:
- 使用量:input、output、total、快取、重試及延遲。
- 工作質量:正確率、遺漏率、無根據內容、格式合規及人工修改時間。
- 風險控制:資料分級、權限、保存期限、模型路由、人工批准及停止條件。
- 商業結果:處理一份文件所需時間、交付週期、退回率及真正被採用的輸出。
當這些欄位一齊看,企業才知道 token 增加係因為工作變複雜、資料變完整,還是中間層重複處理;亦才可以判斷省下來的是時間、成本,還是只係多了一段看似流暢的文字。
10. 下一步:由一個流程開始,建立可驗收的 AI 工作方法
如果你正在評估 AI 課程、企業工作坊或 gateway,第一步可以揀一項不涉及機密資料的實際工作,寫清楚原始資料、輸出格式、人工核對人及接受標準。完成一輪 baseline 後,再比較不同模型或路由。這樣你買到的就唔只係一個 token 數字,而是一套可以解釋、重做及改善的工作流程。
AD-Linkage 可延伸的學習及服務入口
以下入口只作相關方向參考,課程名稱、日期、費用、交付物及服務範圍以各現行產品頁及正式查詢為準:
參考資料
以下官方資料於 2026 年 10 月 1 日核對,用於支持本文的 token 定義、用量分類、上下文及計費概念:
- Google Gemini API:Understand and count tokens——說明 tokenization、輸入與輸出用量、計數方法及 context window。官方頁面標示最後更新為 2026 年 9 月 23 日;當中的英文字符比例及模型上限屬 Gemini 說明,本文沒有把它套用成所有模型的固定換算。
- Google Gemini API:Pricing——按模型及類別分列 input、output(包括 thinking tokens)與 context caching 的計費方式。本文引用的是分類原則,沒有引用或承諾任何固定價格;實際費用以選用服務的現行條款為準。
餐飲比喻、Gateway 核對清單及驗收表是 AD-Linkage 為企業讀者整理的說明方法,並非供應商的效能測試,也不是特定平台已發生問題的證據。