
截至 2026 年 10 月 24 日,Kimi 官方平台已列出 K3.1 Pro。本文拆解官方跑分、API 入口、1M context 及限制,幫香港團隊用可驗收的小試點判斷是否值得測試。
Kimi K3.1 Pro 更新了甚麼?先分清產品入口
Kimi 官方模型文件及產品頁截至 2026 年 10 月 24 日已列出 K3.1 Pro。官方把它描述為 K3.1 系列首個模型,主打程式編寫、3D 創作、金融研究及長程 Agent 工作;產品頁亦列出原生視覺理解及 1,048,576-token context。
這些資料可以用來建立測試假設,但不能直接當成香港帳戶已經具備的功能。至少要分開看三個入口:
- Kimi 網頁/App: 面向一般使用者的產品入口;App 可見模型,不等於 API 帳戶有相同權限。
- Kimi API: 按量計費,模型、充值、速率限制及資料政策另有文件。
- Kimi Code: 針對編程工作的產品體驗,與 API 充值及一般會員方案不能互相推定。
官方文件沒有在本次查閱中提供一個可獨立核對的首次發布日,所以本文寫「截至 2026 年 10 月 24 日官方已列出/宣布」,不把日期寫成全球首次發布。
跑分很高代表甚麼?先看 benchmark 的口徑
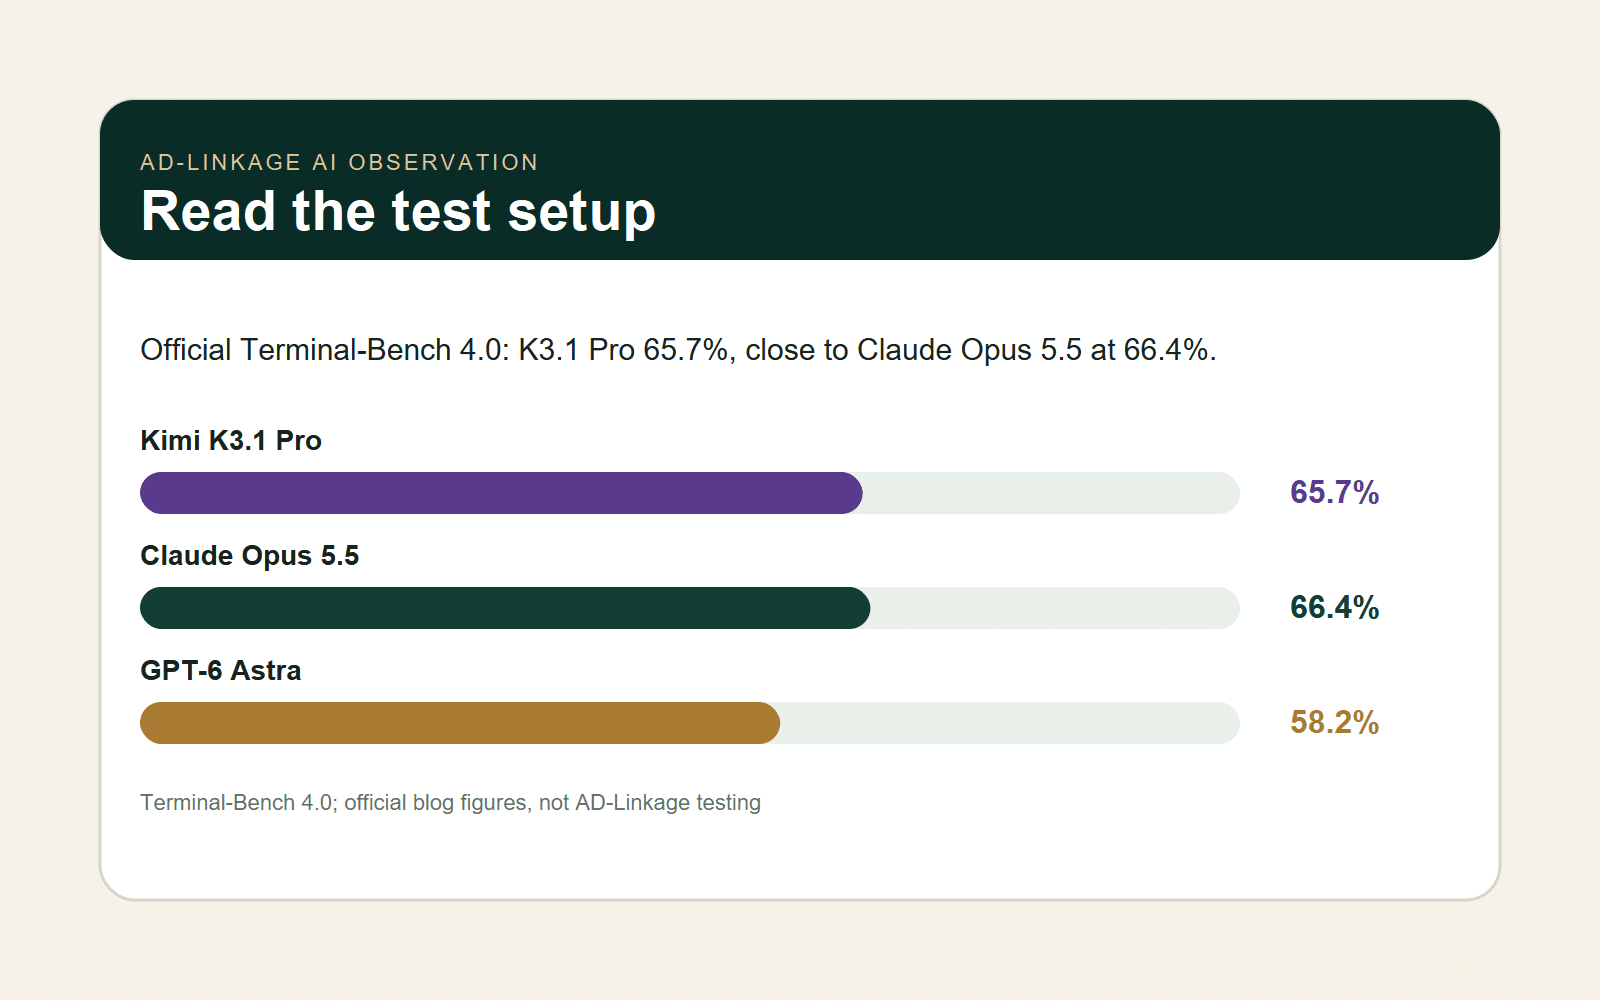
Kimi 官方頁面報告 K3.1 Pro 在 Terminal-Bench 4.0 得分 65.7%,同一頁列出的比較數值為 Claude Opus 5.5 的 66.4% 及 GPT-6 Astra 的 58.2%。這個結果可以說明官方展示的終端 Agent 任務表現值得留意,但不能寫成獨立測試證明它「全球第一」。官方頁面沒有同時提供完整 harness、測試日期、硬件、重複次數、成本口徑及統計誤差。
Kimi 亦列出自己的 Kimi Code Bench 3.0 Long-horizon:K3.1 Pro 為 61.2%,K3 為 55.95%。這是 Kimi 內部 benchmark,沒有公開任務集、評分腳本或獨立復核;可用來理解官方聲稱的前代改善,不能直接變成普遍商業成效。
| 官方資料 | 可以怎樣讀 | 仍要保留的限制 |
|---|---|---|
| Terminal-Bench 4.0:65.7% | 值得把長程終端任務放入候選測試 | 官方頁未交代完整執行設定,不能視為獨立排名 |
| Kimi Code Bench 3.0:61.2% | 官方聲稱比 K3 的 55.95% 高 | Kimi 內部測試,外部不可直接重現 |
| Office QA Pro v2、SpreadsheetBench 2 | 官方聲稱表現領先 | 頁面沒有列出可比較的具體分數與設定 |
| 金融/事實準確度壓力測試 | 可提醒團隊要求來源及人工核對 | 特意集中在容易出錯樣本,不代表日常錯誤率 |
因此,跑分的正確用途是幫你選擇「要測甚麼」,而不是代替你的驗收。
API 有甚麼要核對?1M context 不是即用保證
如果香港團隊想把 K3.1 Pro 接入工作流,先看官方 API 文件,而不是只看 App 畫面。官方目前列出以下可核對項目:
- 上下文: 1,048,576 tokens;重複前綴可使用 context cache,預設 TTL 為 5 分鐘,也可設為 1 小時。這不代表任何長文件都會自動得到可靠答案。
- 思考模式: 一直開啟;
reasoning_effort支援low、high、max,預設為max,目前不能關閉。 - 視覺輸入: 支援圖片及影片檔案,但官方要求以 base64 或
ms://<file-id>傳入;不要把它理解成可以直接讀取任意網頁圖片。 - 工具及聯網: 可用工具呼叫及官方 Formula 工具;官方文件寫明聯網搜尋正在更新,近期不建議用於生產流程。
- 開通與計費: API 文件要求先完成開放平台充值。Kimi 產品頁列出 K3.1 Pro 每 1 MTok 的 input US$2、output US$10;Highspeed 為 input US$4、output US$20。這是查閱日的官方產品頁口徑,不是香港月費或長期保證。
官方 API 文件亦寫明完整模型權重預計在 11 月 4 日前發布,這是計劃日期,不能寫成 10 月 24 日已經公開下載。帳戶地區、付款、速率及資料處理條件仍要由團隊用自己的入口核對。
價格比較:同一個 1M tokens,並不代表同一個方案
以下只比較官方 API 標準按量價,查閱日期為 2026 年 10 月 24 日。各家對 cache、長度分層及即將生效日期的寫法不同,不能只看一個 input 數字便下結論。
| 模型(API) | Input/1M tokens | Output/1M tokens | Cache/其他條件 |
|---|---|---|---|
| Kimi K3.1 Pro | US$2.00 | US$10.00 | Cache write US$2.00;cache hit US$0.20 |
| Claude Sonnet 5.5 | US$2.00 | US$10.00 | Prompt cache read US$0.10;write US$2.50 |
| Gemini 4 Argon | US$2.00(至 11 月 30 日);US$4.00(12 月 1 日起) | US$10.00(至 11 月 30 日);US$20.00(12 月 1 日起) | Paid tier;不在 Free tier;implicit caching |
| Gemini 2.5 Pro | US$1.25(prompt ≤200K);US$2.50(>200K) | US$10.00(≤200K);US$15.00(>200K) | Cache US$0.125/US$0.25,按 prompt 長度分層 |
以 100K input 加 20K output 作粗略例子(不計 cache、搜尋、工具及稅項),Kimi、Claude Sonnet 5.5 及 Gemini 4 Argon 在 11 月 30 日前約為 US$0.40;Gemini 2.5 Pro 在 200K 以內約為 US$0.325。這只反映 token 價,沒有反映答案品質、速度、context 上限、地區資格或人工覆核成本。
因此,價格比較的用途是先估算採用成本;真正選型仍要把同一批資料、同一提示詞、同一覆核門檻放入小試點。API 按量價亦不等於 App 或 coding 產品的月費。
香港團隊應如何做一個小型測試?
先說清楚:以下「小型測試」是可執行的驗收設計,不是 AD-Linkage 已經跑過的 Kimi API 測試。 我們目前沒有登入 Kimi、充值、呼叫 API 或取得香港帳戶的速度/品質結果,所以不能把它寫成「已證明有效」。
與其把「65.7%」直接換成採購決定,不如用一項不含敏感資料的真實工作做小試點。以下以 AD-Linkage 的合成例子說明,數字和結果都不是公司實際成效:
假設團隊要把公開的市場文章、產品 brief 及 CSV 整理成一頁 campaign brief。可以同時測試 K3.1 Pro、K3.1 Pro Highspeed 及現用模型,固定輸入、提示詞、輸出格式及同一位覆核者。記錄:
- 來源正確性: 每個數字、日期及結論能否回到原文。
- 完整性: 有沒有漏掉限制、例外及需要人決定的欄位。
- 穩定性: 相同輸入重跑三次,格式與關鍵結論是否一致。
- 成本與速度: input/output token、cache、重試、首次回應及完成時間。
- 人工工作: 審閱、修正及重跑花了多少時間,是否真的減少工作。
把輸入、模型版本、reasoning_effort、工具設定、輸出、人工修改及評分表保存下來。若仍要人工重寫大部分答案,或者來源錯誤超過團隊門檻,就保留原配置,暫停切換。這樣才可以把官方跑分變成與自己工作有關的問題。
模型跑分之外,真正要設計的是工作流
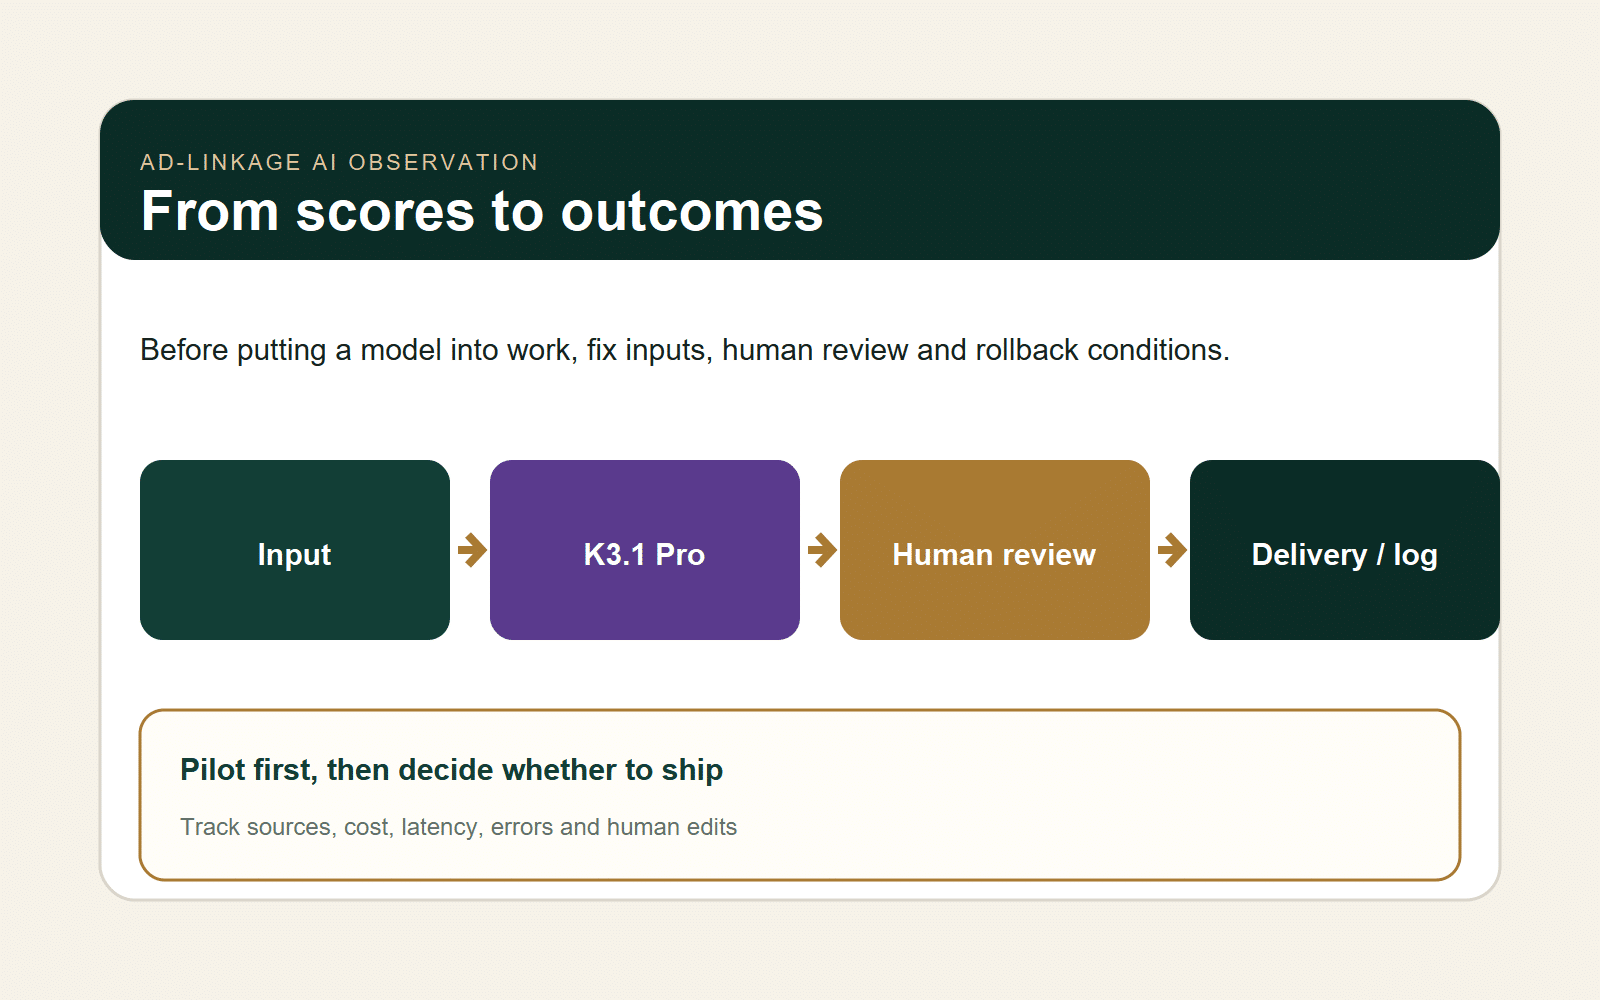
K3.1 Pro 值得測試,原因不是一個百分比可以保證成效,而是它把長上下文、視覺理解、工具呼叫及長程 Agent 放在同一個候選方案中。團隊仍要設計完整交接:輸入 → AI 處理 → 人工覆核 → 輸出 → 留檔/交接。
PCPPMAI/CEF AI 課程可作 AI 商業應用及工作流程方法的學習入口;本文沒有把 Kimi、API 充值、Kimi Code 或任何模型服務寫成課程內含物。若你要評估新模型,應先定義資料規則、覆核位置、失敗時由誰接手,再比較模型。
延伸閱讀: DeepSeek-V4.1-Flash-1017 Token Plan 更新、Wan 3.0 AI 影片工作流 及 Qoder Cloud Agents。
下載:Kimi 小型驗收任務規格
以下規格用公開或合成資料設計比較,不是 Kimi 官方測試,也不是 AD-Linkage 已完成的 API 實測。不同 AI、帳戶入口、版本及資料格式可能需要調整提示詞;先用少量非敏感資料核對。
# Kimi K3.1 Pro 小型驗收任務規格

用途:用公開或合成資料,比較 Kimi K3.1 Pro、K3.1 Pro Highspeed 及現用模型是否適合一項指定工作。這不是 Kimi 官方 benchmark,也不是 AD-Linkage 已完成的 API 實測。

## 工作目標

- 指定一項可重複的工作,例如把公開市場文章、產品 brief 及 CSV 整理成一頁 campaign brief。
- 比較成本、速度、來源正確性、完整性、穩定性及人工修正時間。
- 明確寫出通過、回退及需要人決定的位置。

## 固定條件

- 測試資料:公開或合成資料,不包含客戶、學生、個人或公司機密。
- 輸入集:至少短、中、長三種長度;保存版本及來源。
- 提示詞及輸出格式:除模型 ID、`reasoning_effort` 或明確要測的配置外保持一致。
- 覆核者:同一位或同一套評分表,記錄引用、漏項、格式及可用性。

## 記錄欄位

| 類別 | 欄位 |
| --- | --- |
| 帳戶 | 入口、地區、方案、模型 ID、查閱日期 |
| 成本 | input/output token、cache、實際扣款、重試 |
| 速度 | 首次回應、完成時間、超時 |
| 品質 | 引用正確、漏項、格式、敏感資料 |
| 穩定 | 相同輸入重跑、錯誤訊息、輸出一致性 |
| 人工 | 審閱、修改、重跑所需分鐘 |

## 回退條件

若來源錯誤、漏項、超時或人工修正時間超過團隊門檻,保留舊配置,停止切換並交負責人決定。測試完成不代表可直接接入生產流程、對外發布或更改付款方案。
資料來源及本文驗證範圍
資料核對日期:2026 年 10 月 24 日(香港時間)。價格比較使用 Kimi/Moonshot、Anthropic 及 Google 官方頁面;本文沒有登入、充值、香港帳戶或 API 實測。
- Kimi API:Kimi K3.1 Pro quickstart(模型規格、benchmark 及限制)
- Kimi 開放平台產品頁(產品卡及查閱日價格)
- Kimi AI 產品入口(App 入口)
- Kimi API 計費說明(按量計費及 cache)
- Terminal-Bench(官方引用的外部 benchmark 入口;本文沒有重新跑測試)
- Anthropic API pricing(Claude Sonnet 5.5 官方價格)
- Google Gemini API pricing(Gemini 4 Argon 及 Gemini 2.5 Pro 官方價格與日期分層)
官方自報 benchmark、產品頁價格及 API 資格會隨版本、帳戶及地區更新;讀者應在採用前重新核對。
常見問題
Kimi K3.1 Pro 是不是 Kimi 3.1?
正式名稱是 Kimi K3.1 Pro,屬 K3.1 系列首個模型。文章以官方模型文件和產品頁的名稱為準,不把它簡化成沒有產品後綴的「Kimi 3.1」。
Terminal-Bench 4.0 的 65.7% 是否代表 Kimi 一定最好?
不是。65.7% 是 Kimi 官方頁面報告的數字;頁面列出 Claude Opus 5.5 為 66.4%。缺少完整測試設定、成本及獨立復核,不能用來保證你的工作表現。
有 Kimi App 會員就可以用 API 嗎?
不能直接推定。App、API 及 Kimi Code 是不同產品入口;API 的充值、模型資格、速率限制及資料政策要以官方開放平台文件和你的帳戶為準。
Kimi K3.1 Pro 的 API 價格是多少?
截至 2026 年 10 月 24 日,官方產品頁列出 K3.1 Pro 每 1 MTok input US$2、output US$10;cache write US$2、cache hit US$0.20。Highspeed 為 input US$4、output US$20;這是 API 按量計費,不是 Kimi App 或 Kimi Code 月費,也不是香港帳戶的固定報價。
Kimi 同 Claude、Gemini 的 API 價錢可以直接比較嗎?
可以先用每 1M tokens 做成本估算,但不能當成完整選型。Kimi K3.1 Pro 與 Claude Sonnet 5.5 目前同為 input US$2、output US$10;Gemini 4 Argon 在 2026 年 11 月 30 日前也是 US$2/US$10,12 月 1 日起官方頁面列出 US$4/US$20;Gemini 2.5 Pro 則按 prompt 是否超過 200K tokens 分層。cache、搜尋、工具、速率及地區資格仍要逐項核對。
1M context 是否代表可以放心上載整個公司資料庫?
不是。上下文容量不等於權限、正確性或資料治理。先用公開/合成資料,設定可用資料範圍、引用要求及人工覆核,再決定是否接入工作流。
K3.1 Pro Highspeed 一定比較適合香港企業嗎?
不一定。官方標示 Highspeed 輸出速度約為 Pro 的 2–3 倍,但速度、成本、配額及品質仍要用同一測試集核對;不要把產品頁標示當成你的延遲保證。
下一步:先建立可驗收的 AI 工作流
比較模型之前,先定義輸入、驗收、人工覆核及回退條件。


